这篇先聊四个常见的运维麻烦,再看 OpenOcta 的四个对应方案。
四大痛点
痛点 01 / 04:查一个问题,要切好几套系统
查一个服务为什么变慢,往往要先打开好几套系统。
先去 CMDB 找服务部署在哪些主机、归谁负责,再到 Prometheus、Zabbix 看指标和主机状态。
接着打开 APM 找慢在哪段调用,到 ES 翻对应时间的日志,最后去变更系统核对最近有没有发布。
每换一处,就要重新找服务、选时间、设筛选条件。有的地方用服务名,有的地方要主机 IP。
查到的信息还得自己放在一起对照。发现新线索,又要切回前面的系统继续找。
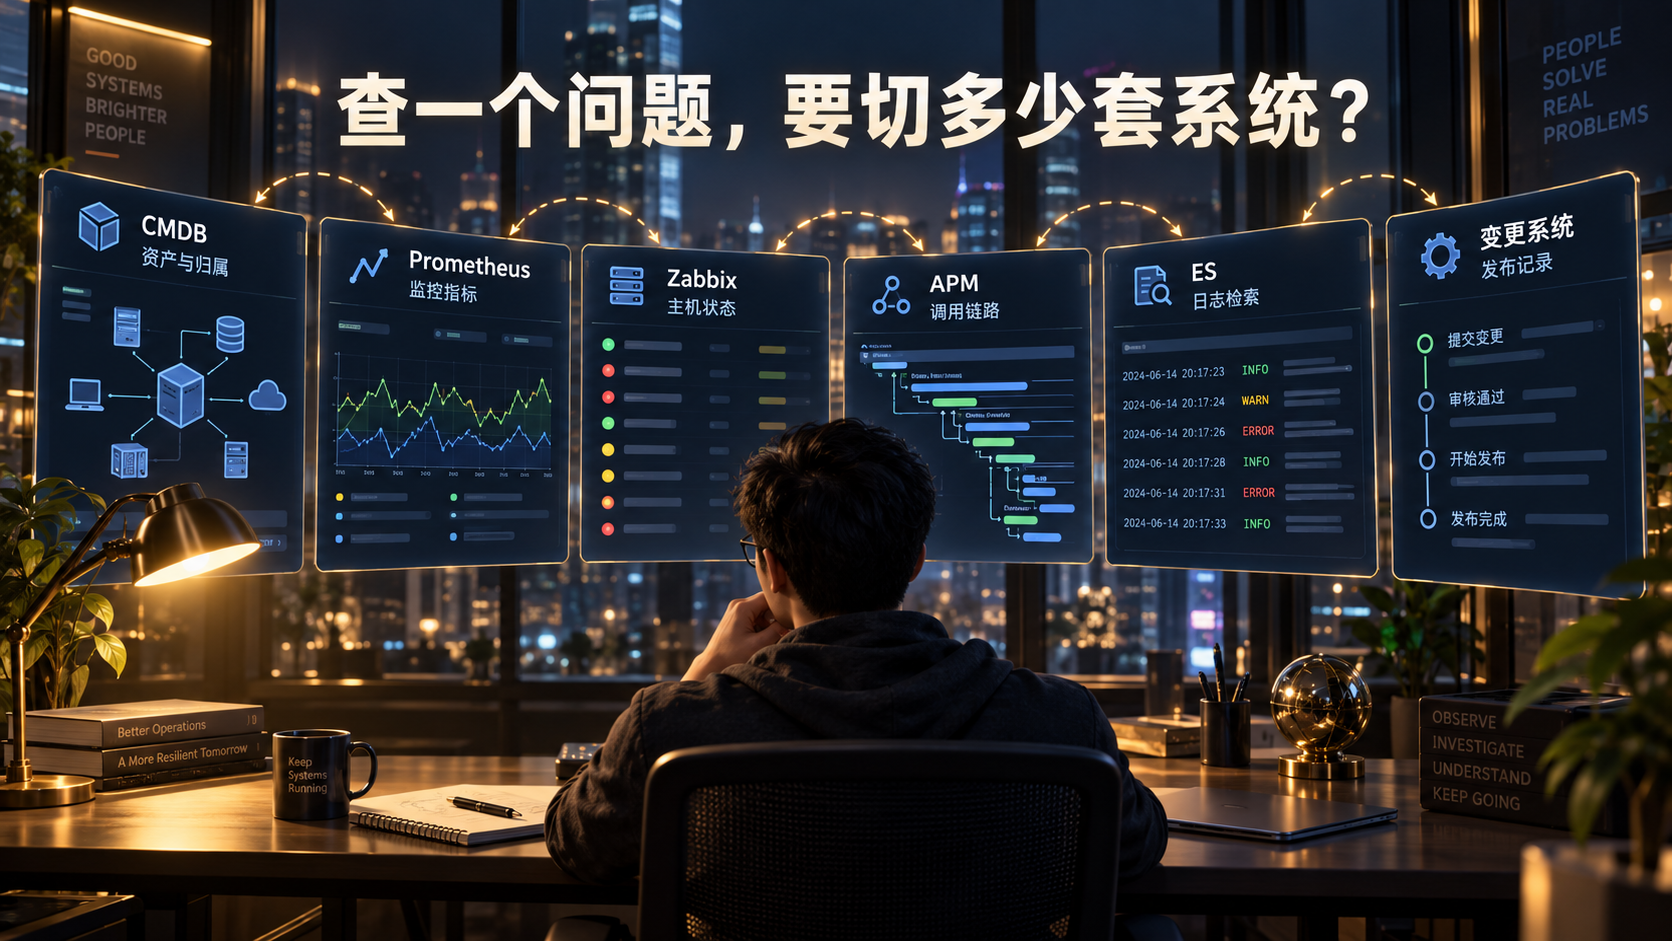
痛点示意:同一个问题,资产、指标、链路、日志和变更记录分散在多套系统。
要是这些系统能接到一起,我在一个地方问问题,它就能帮我去查、拿着结果接着分析,就好了。
痛点 02 / 04:告警到处响,重复消息还得自己辨认
Prometheus 来了一条告警,Zabbix 那边也有提示。你打开两个页面,核对服务、主机和时间,想弄清楚它们有没有关系。还没查完,同一个异常又报了一次。
没有统一看板,哪些是新问题,哪些只是重复通知,都要先靠人辨认。好不容易找出需要处理的那条,后面还有查指标、翻日志、找处理办法的一串操作。
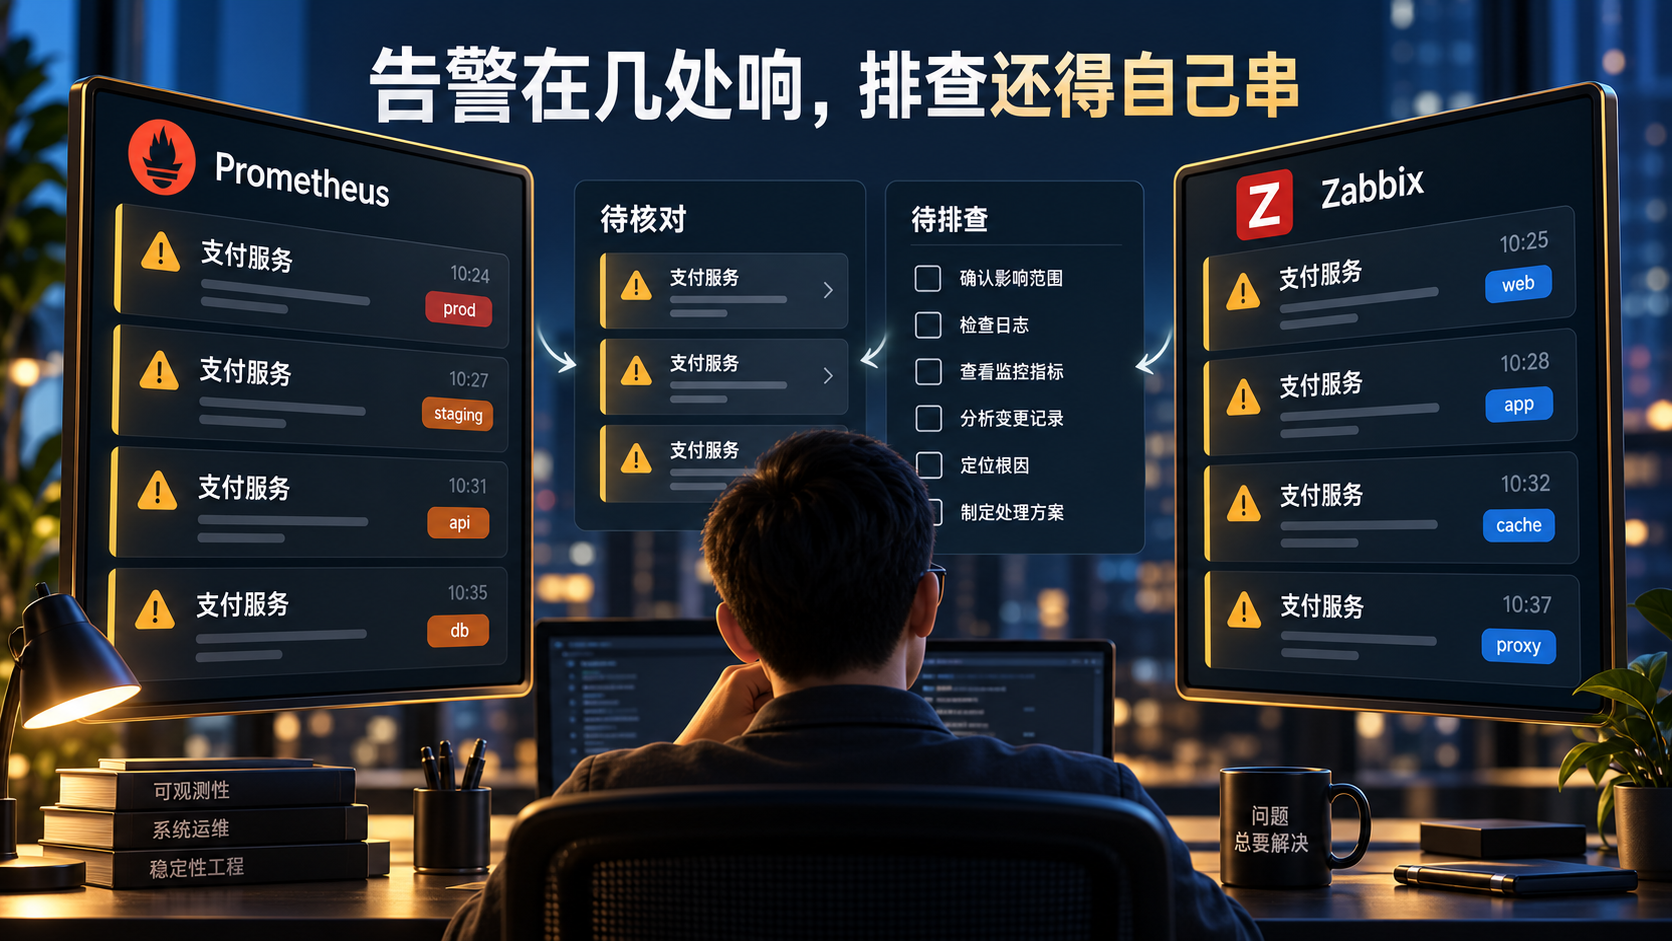
痛点示意:几处都在告警,先辨认重复消息,再开始排查。
要是这些告警能在一处看清,重复的先合在一起,后面的排查和处理也能接着做,就好了。
痛点 03 / 04:日、周、月的重复工作,还得手动做
没有告警打断,也有不少重复工作。
每天巡检,几个核心服务的状态、指标要逐项看。发现异常,再去查相关信息;查完,还得整理结果。
脚本能跑一部分,但先跑哪个、跑完接着查什么,往往还要人盯着。
要是把要查的服务和检查步骤说清楚,就能自动跑完,有异常接着分析,最后给我一份巡检结果,就好了。
每周回看遗留问题,上周哪些告警还没处理完,哪些异常又出现了?记录分散在几个系统里,需要按业务和时间逐一核对。
要是能按上周的记录,把没处理完和反复出现的问题先列出来,就不用每次重新找一遍了。
月底整理运行汇总,又要取告警、巡检和处理记录,按负责的业务做统计、看趋势。表格格式没怎么变,下个月换一批数据,同样的取数和整理还得再来。
要是我说清统计哪些业务、哪个时间段,就能把这份汇总准备好,该多省事。
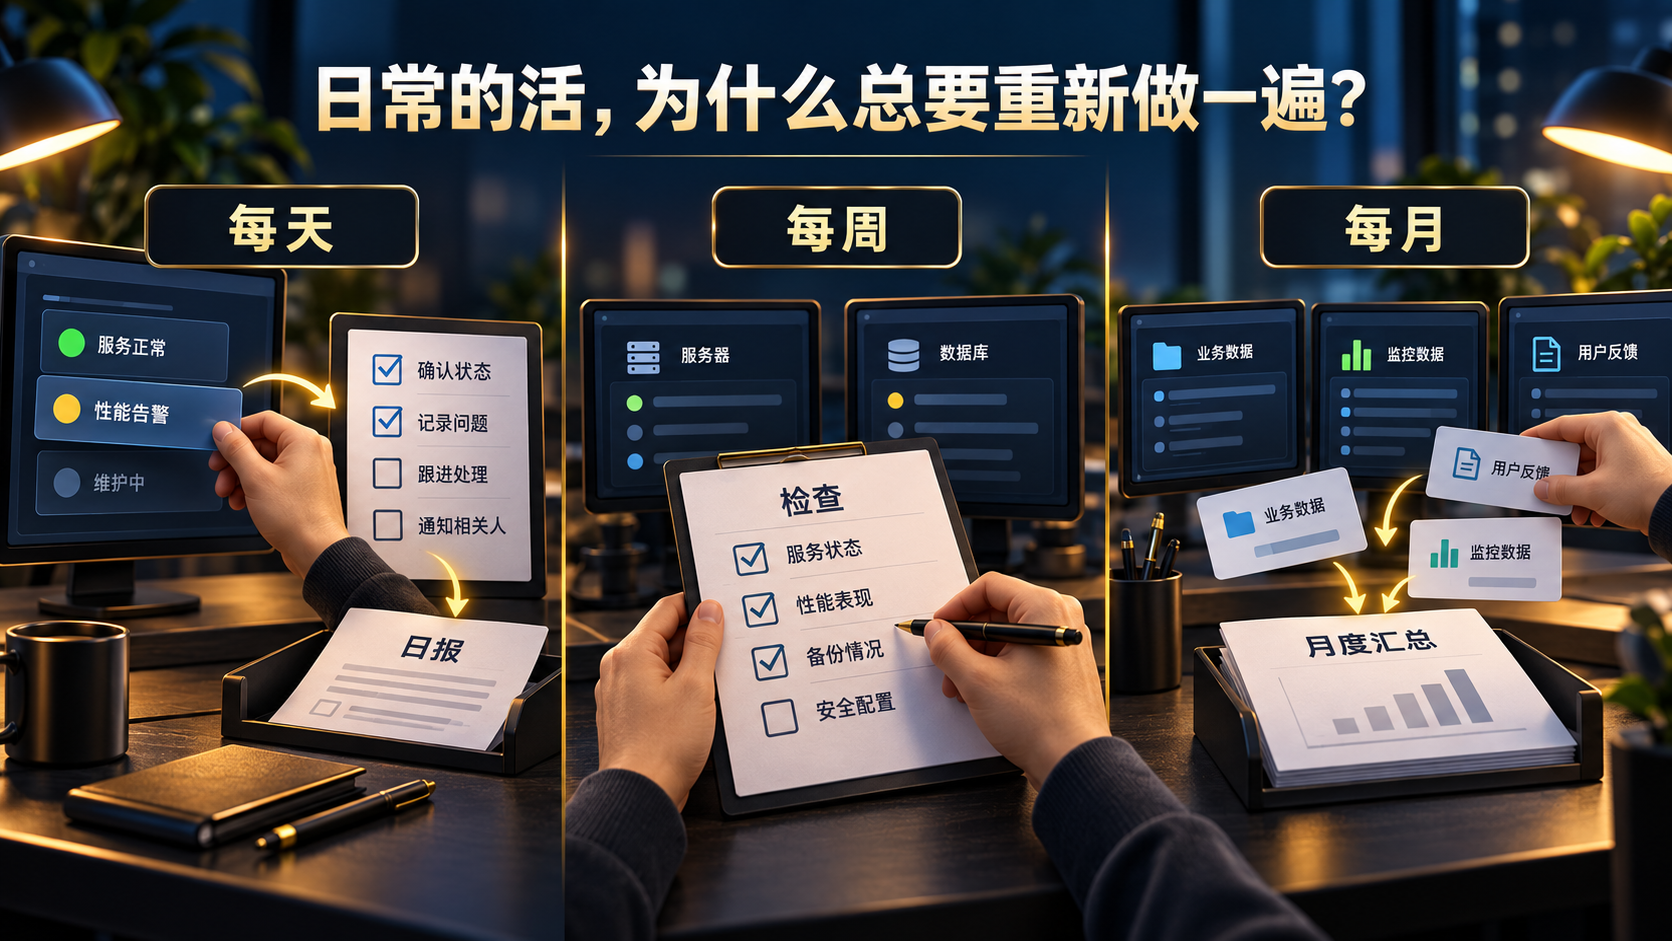
痛点示意:每天查状态、每周追问题、每月做汇总。
痛点 04 / 04:固定页面,未必适合自己的工作
值班时,你想先看自己负责的业务是否正常,有哪些告警,巡检查出了什么。
准备变更时,关注的是这次涉及的系统和检查结果。到了月度回顾,又需要看一段时间里的运行趋势。还是同一个人,做的事情变了,想看的内容也跟着变。
固定看板往往只能满足一部分需求。其余内容得自己筛选、拼到一起。想多看一个业务,或者换一种统计方式,有时还得再提一次页面需求。
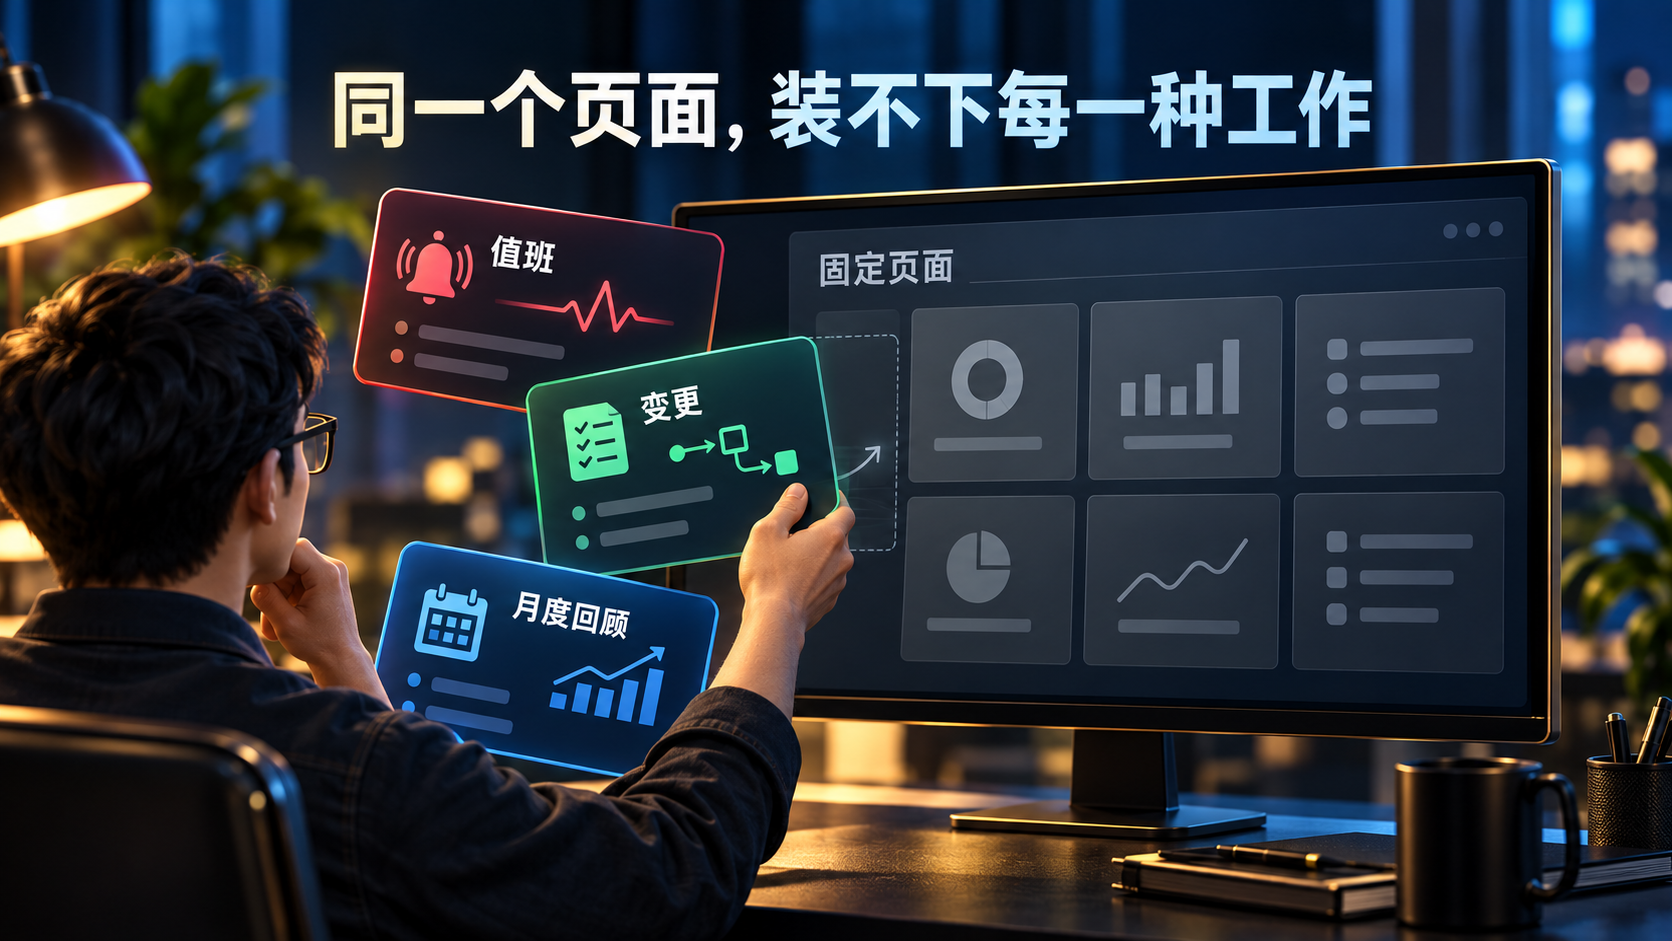
痛点示意:手头的工作换了,页面也得跟着变。
要是我说清负责哪些业务、要做什么,就能生成适合我的运维场景,之后想改还能接着说,就好了。
四个对应方案
方案 01 / 04:多系统对接,围绕一个问题连续查
CMDB、Prometheus、Zabbix、APM、ES,以及团队自己的变更系统,都可以按各自提供的接口和工具接入 OpenOcta。
OpenOcta 支持 MCP、API、CLI 等对接方式,已有系统的查询能力可以继续用起来。
系统的连接、访问权限和调用说明配好后,你就可以这样问:
查一下支付服务最近半小时为什么变慢,顺便看看这段时间有没有发布。
AI 按问题需要,从 CMDB 查服务对应的资源,从监控和 APM 查异常指标与慢调用,再结合 ES 日志、近期变更记录分析原因。
你在同一个对话里继续追问,它按需调用不同系统,拿到数据后接着查。
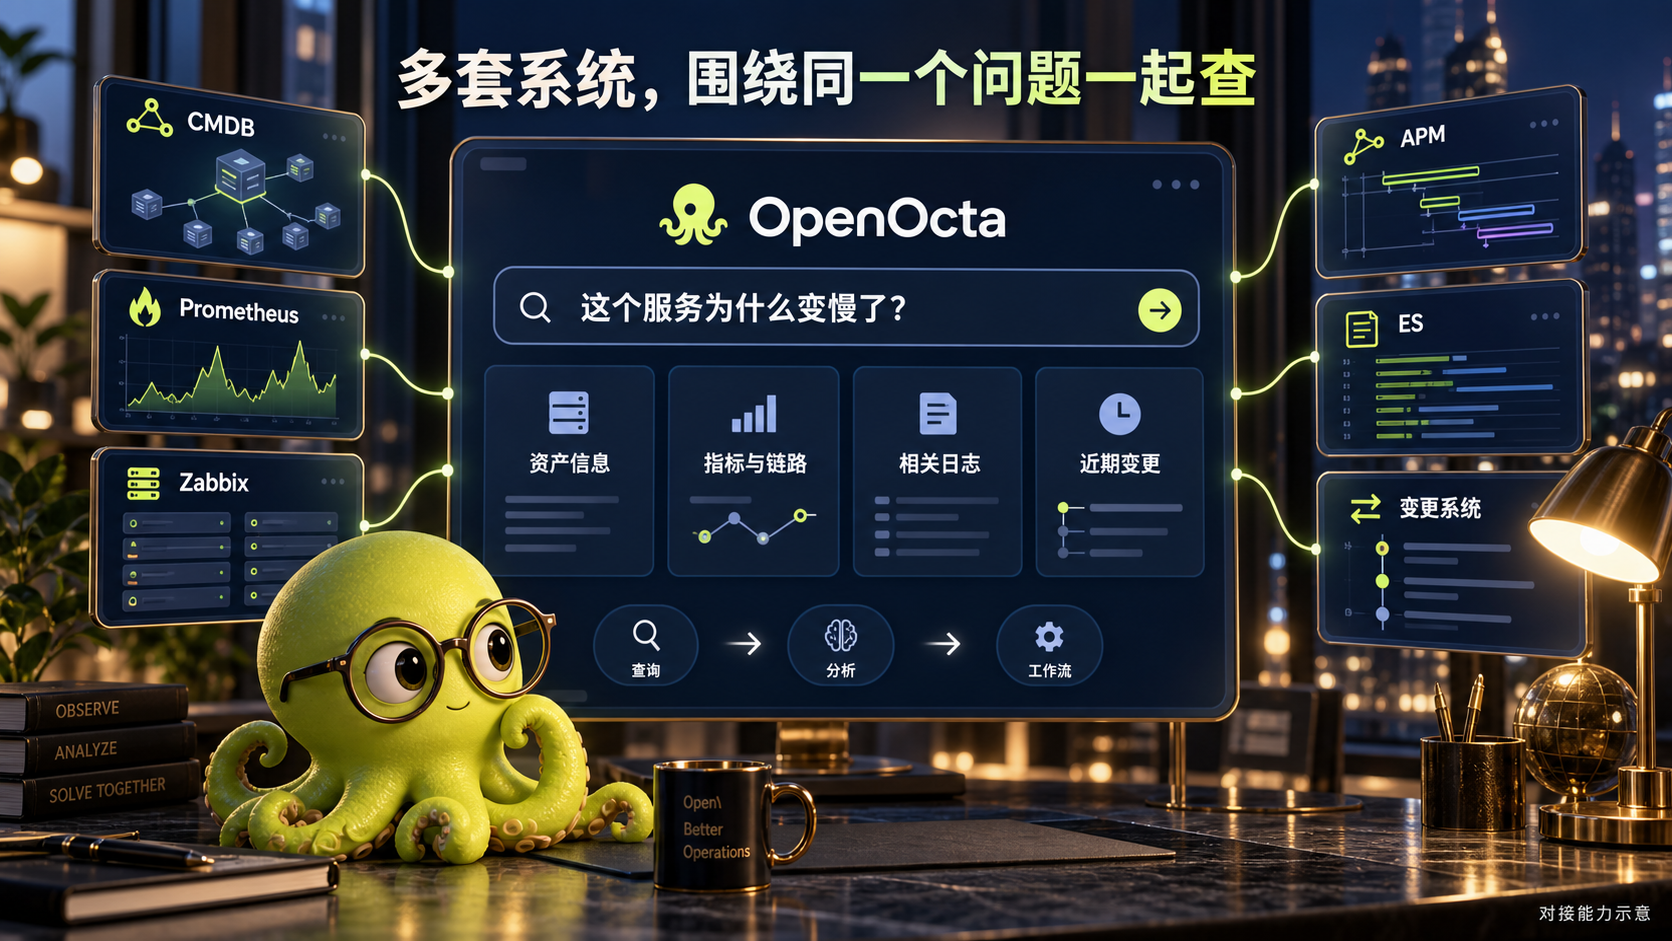
方案示意:各系统提供查询能力,OpenOcta 围绕同一个问题获取资产、监控、链路、日志和变更信息。
复制服务名、反复选时间范围、搬运查询结果的操作,就能少一些。这些对接能力,也能供工作流和运维场景使用。
方案 02 / 04:统一告警、规则收敛,接上工作流处置
Prometheus、Zabbix 等系统送来的告警,则进入统一告警看板,来源、对象和状态一起查看。
同一对象反复出现的同类异常,可以按配置的标签和时间窗口收敛,集中跟进。原始事件仍然保留,需要时可以查看每条记录。
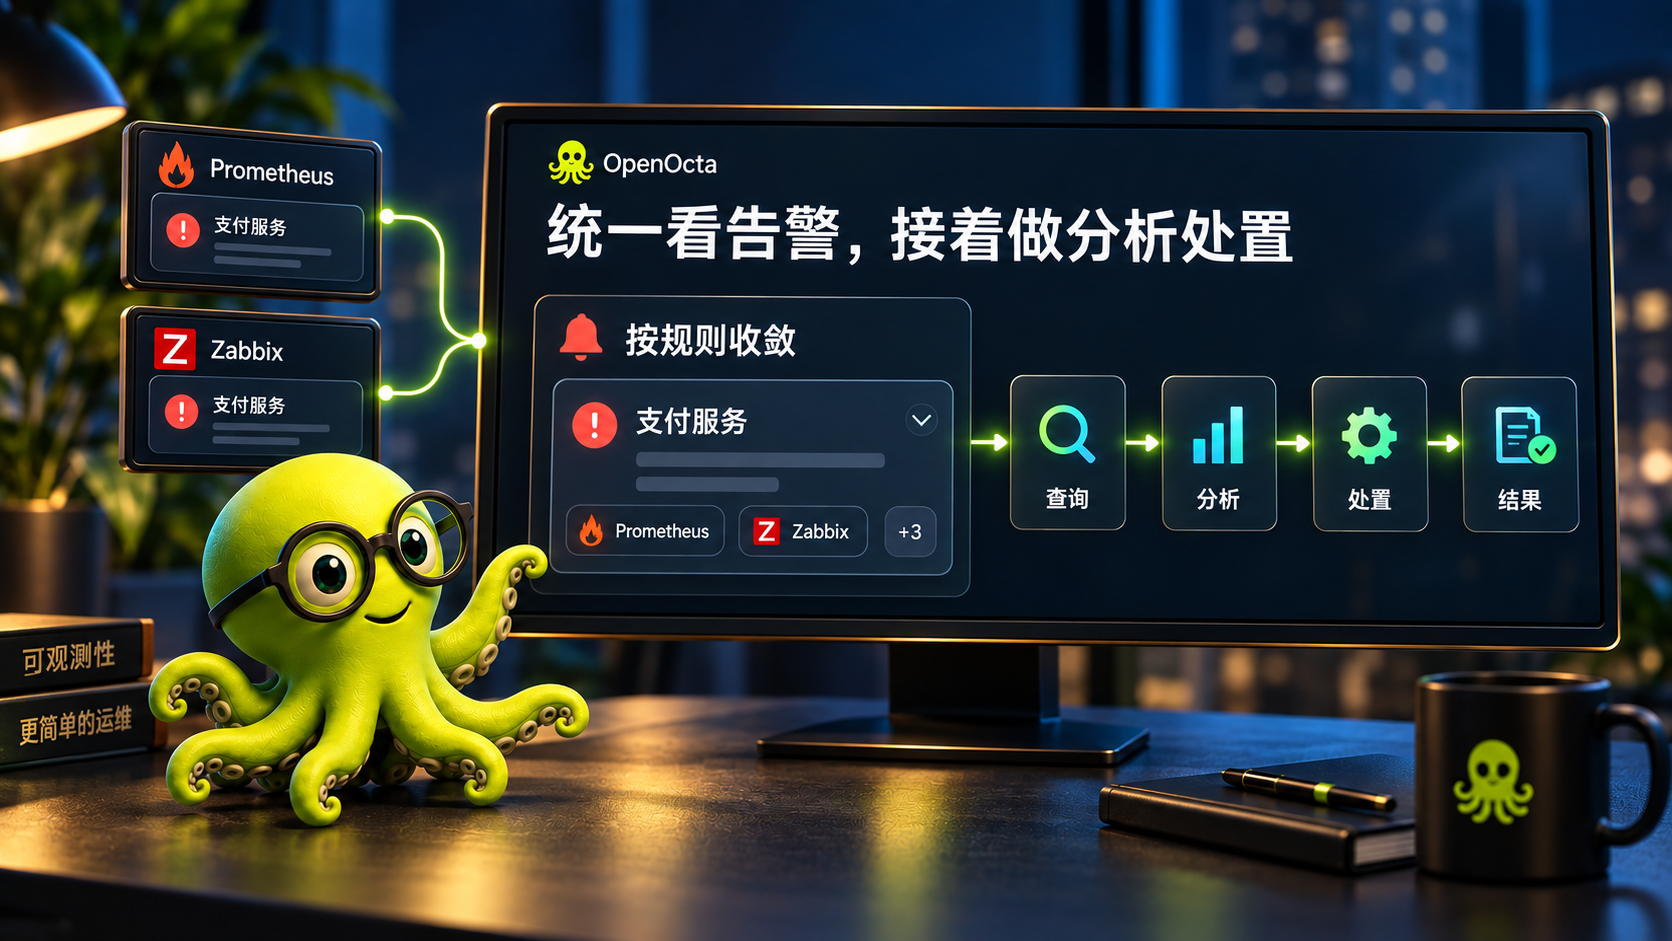
方案示意:多源告警统一查看、按规则收敛,再交给关联的工作流分析处置。
接着,为这类告警关联一条处理工作流:先调用已接入的监控、APM 和日志系统查询异常,再由 AI 分析,按预设步骤处置。
工作流会带上告警信息执行,收到这类告警后,就能按已有流程继续排查。
哪些步骤自动执行、哪些需要人工确认,按你的设置来。处理进行到哪一步、得到了什么结果,也能继续查看。
方案 03 / 04:按需生成工作流,自动执行重复步骤
前面说的每日巡检、每周回顾、每月汇总,也可以交给工作流。它们各有各的做法,流程可以按你的要求生成。
比如,把巡检需求写下来:
先从 CMDB 找出我负责的服务,再检查运行状态;发现异常就查相关指标和日志,整理一份巡检报告。
AI 根据需求生成工作流。你可以查看每一步要做什么,调整检查范围和处理步骤,再试跑一次。
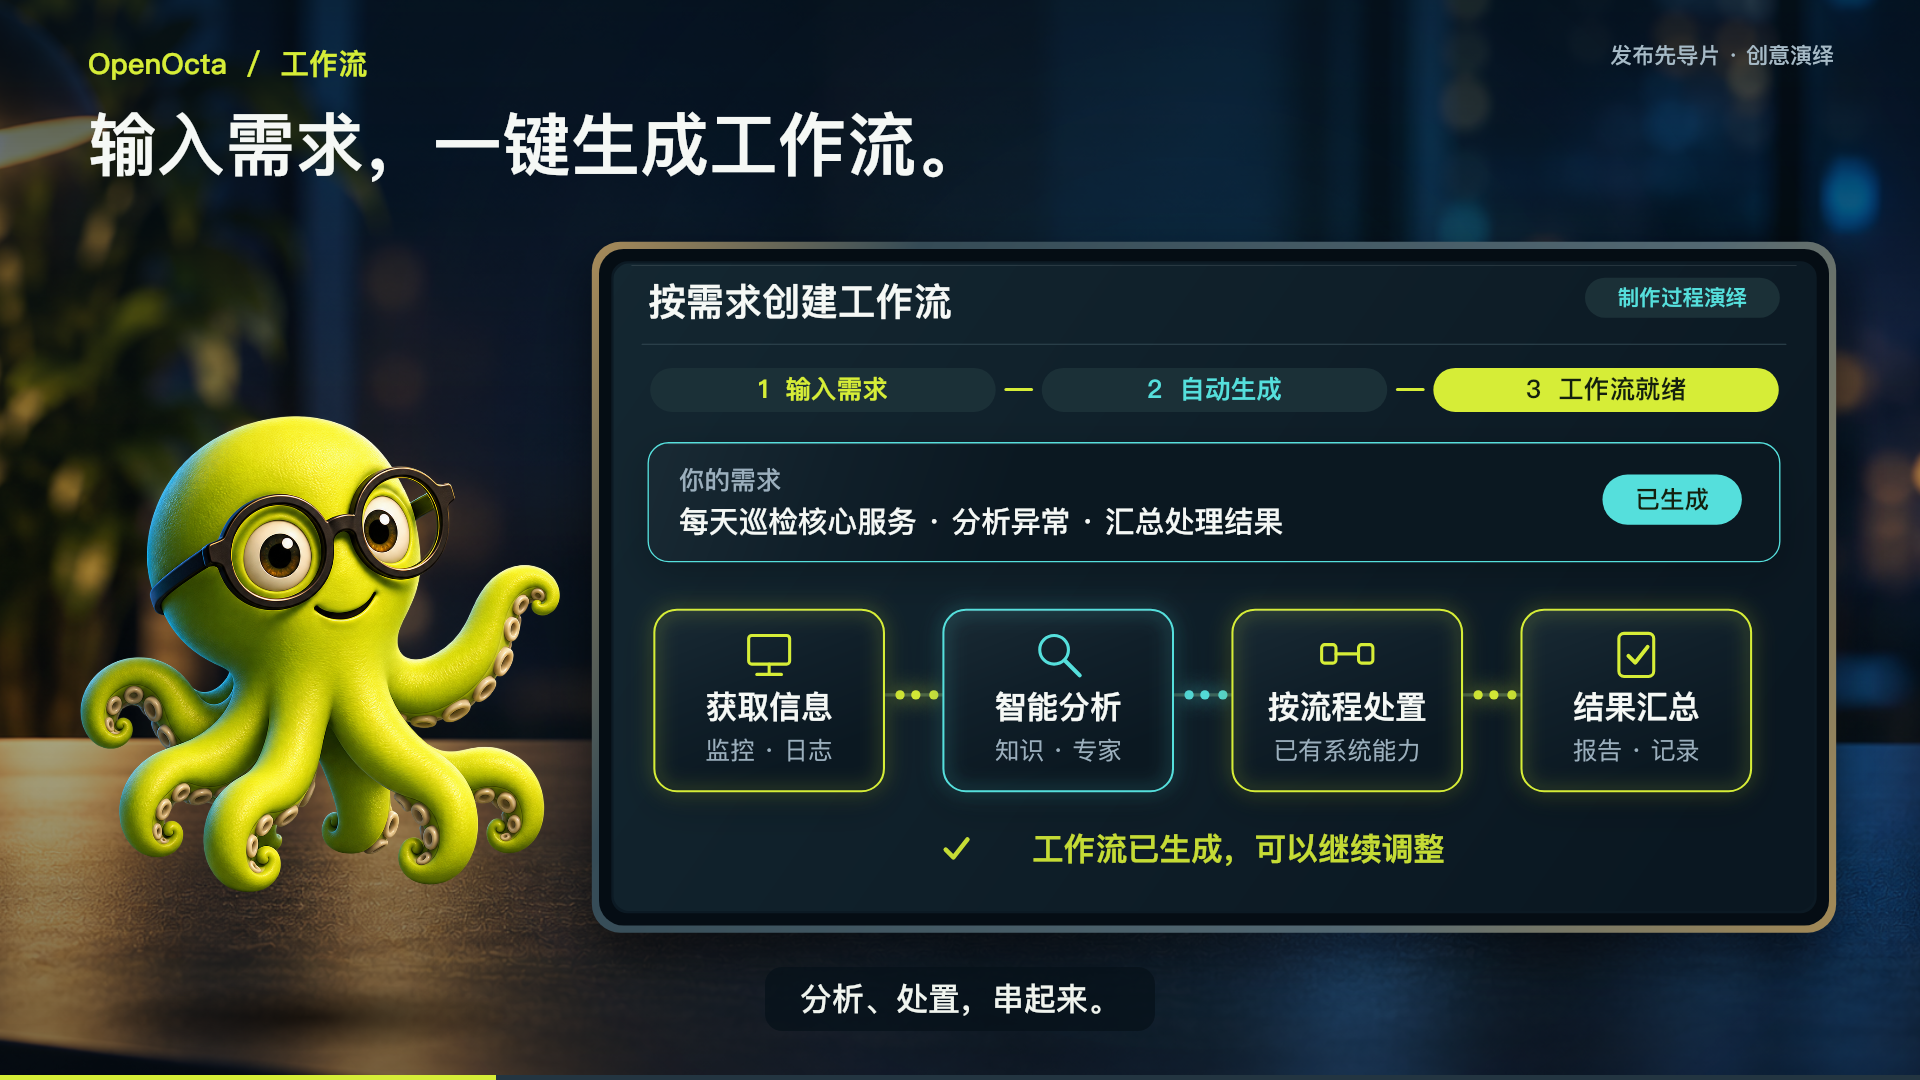
先导片演绎:写下需求,生成工作流,再查看和调整步骤。
接好所需系统、确认流程后,工作流就能调用工具执行查询、检查、分析和汇总。
原来要手动把上一步结果交给下一步的操作,可以由它连续完成。需要你判断的地方,仍然可以留人工确认。
每周回顾,可以按指定时间查告警和处理记录,整理遗留问题;每月汇总,可以按业务取数、统计、生成报告。
流程保存下来,之后换一个时间范围,就能按同样的步骤再跑。
方案 04 / 04:按需生成运维场景,适配自己的工作
再来看那张不太合用的固定页面。你可以直接描述自己要用的场景:
给支付业务做一个值班场景,把服务健康、重点告警、近期变更和巡检工作流放在一起。
AI 按这份需求生成页面,从已经接入的多套系统取数。资产、监控、告警和变更信息,可以按你关心的业务放在同一个场景里。
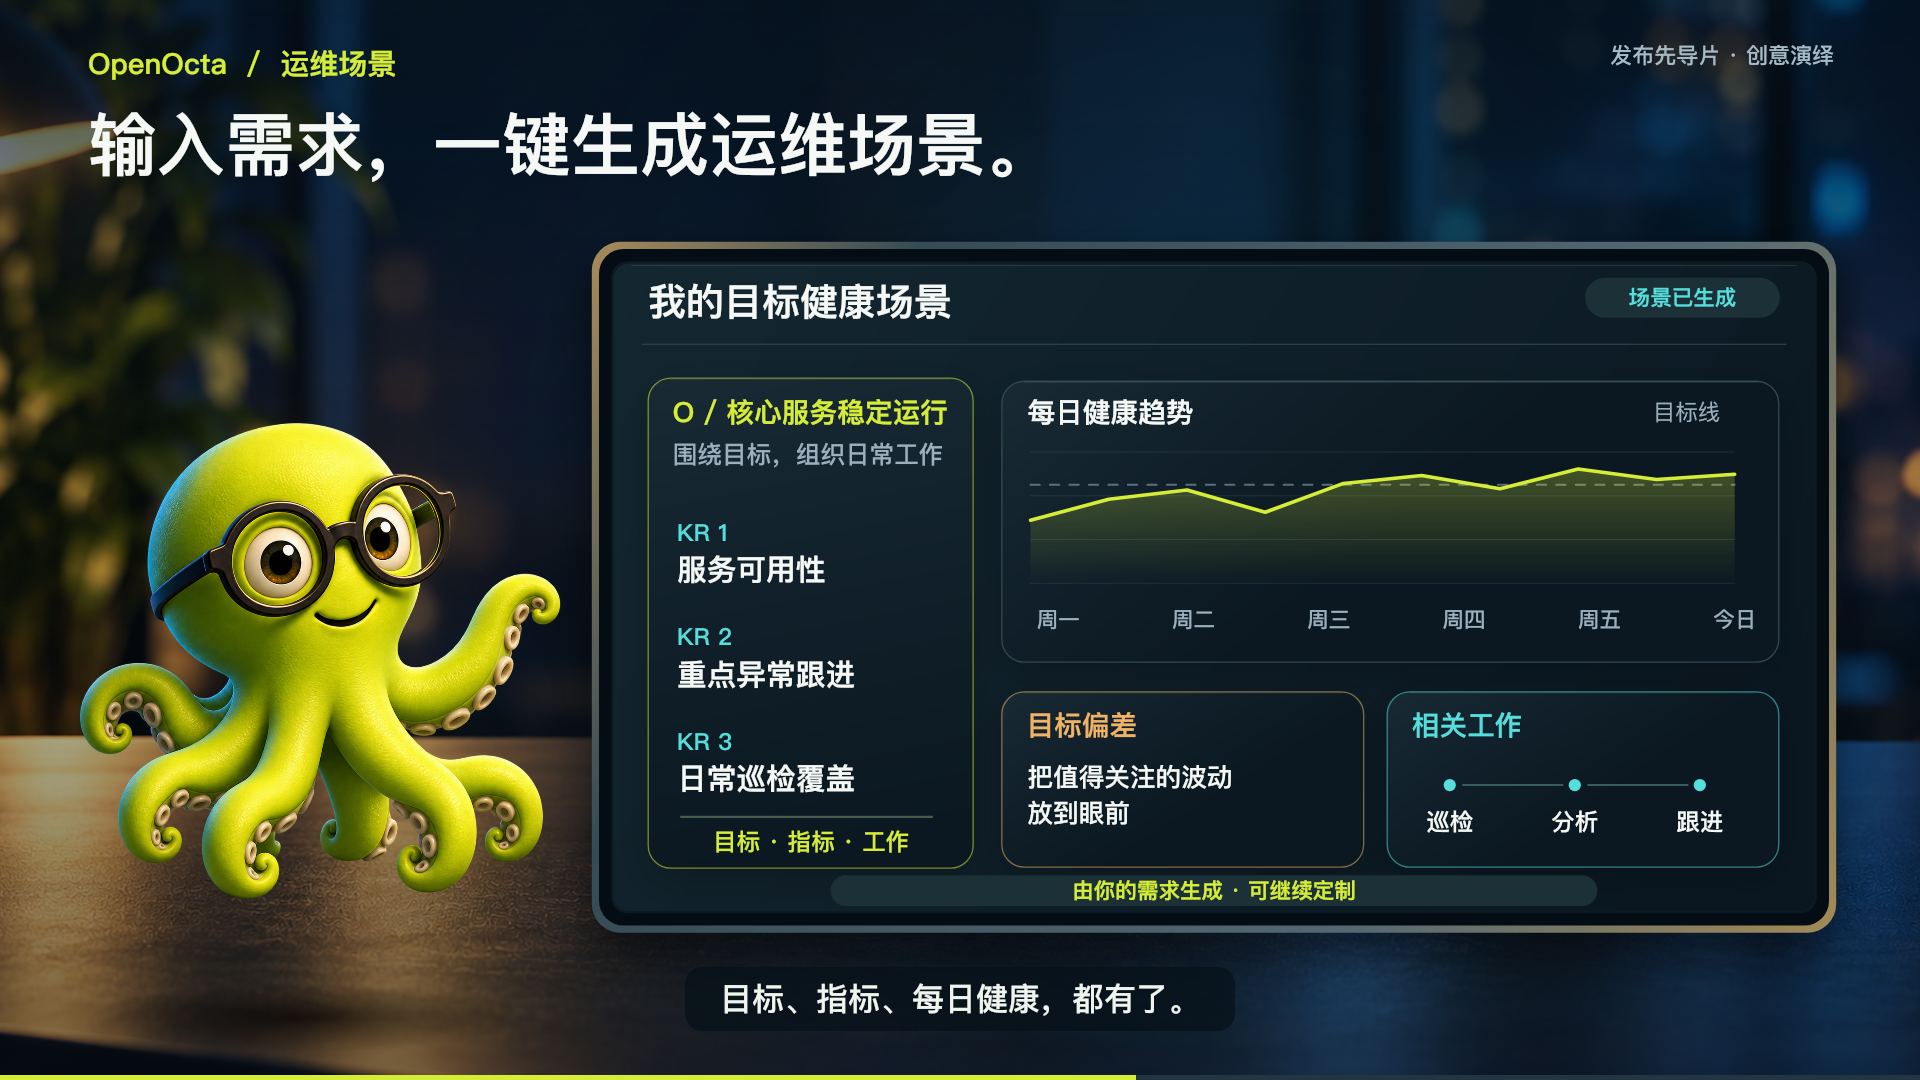
先导片演绎:按需求生成日常使用的运维场景。
生成的场景可以继续查询数据、切换时间范围。想补一项趋势,或者换掉不常看的内容,也可以继续提出修改要求。
做月度回顾时,还可以另外生成一个场景,专门看运行趋势和统计。日常值班用哪张,月度回顾用哪张,按自己的工作习惯来。
OpenOcta 发布预告
这就是即将发布的 OpenOcta。这次先透露几个片段,后续会把实际的使用过程完整展示给大家。
9 月 15 日晚上 7 点
OpenOcta 正式发布