运维这边,Metric、拓扑、调用链、日志,哪样都不缺。缺的是出了事,得人自己把这四样对上。
举个例子,你看入口服务,响应码 200、错误率还是 0%,一眼下去像是没事,排查就容易停在这一页。可真正出问题的地方在下游——SQL 早就抛了异常,你正看的这一页根本看不见。
- Metric — 谁慢、谁在报错
- 拓扑 — 上下游谁红了
- Trace — 耗时卡在哪一跳
- Log — 拿调用 ID 搜原文
时间窗自己对,调用 ID 自己拷,换一页再搜一遍——四页之间全靠人传话。
- Metric 先定对象
- 拓扑看下游
- Trace 拆那一跳
- Log 对上原文
- → 巡检报告
它叫 DataBuff,仓库在 GitHub:https://github.com/databufflabs/databuff。下面用官方 Demo 走一遍这条对话,看它怎么把四页对上。
官方 Demo 里,service-a / service-b 在打 GET /demo/checkout。对话贴这句:
找出最近 1 小时平均响应时间最高的服务,对它进行故障定位- 它先把这句话拆成两步:先找出最近 1 小时最慢的服务,再对它做故障定位。
- 第一刀派给智能问数,时间窗钉在最近 1 小时,先把服务列表拉出来。
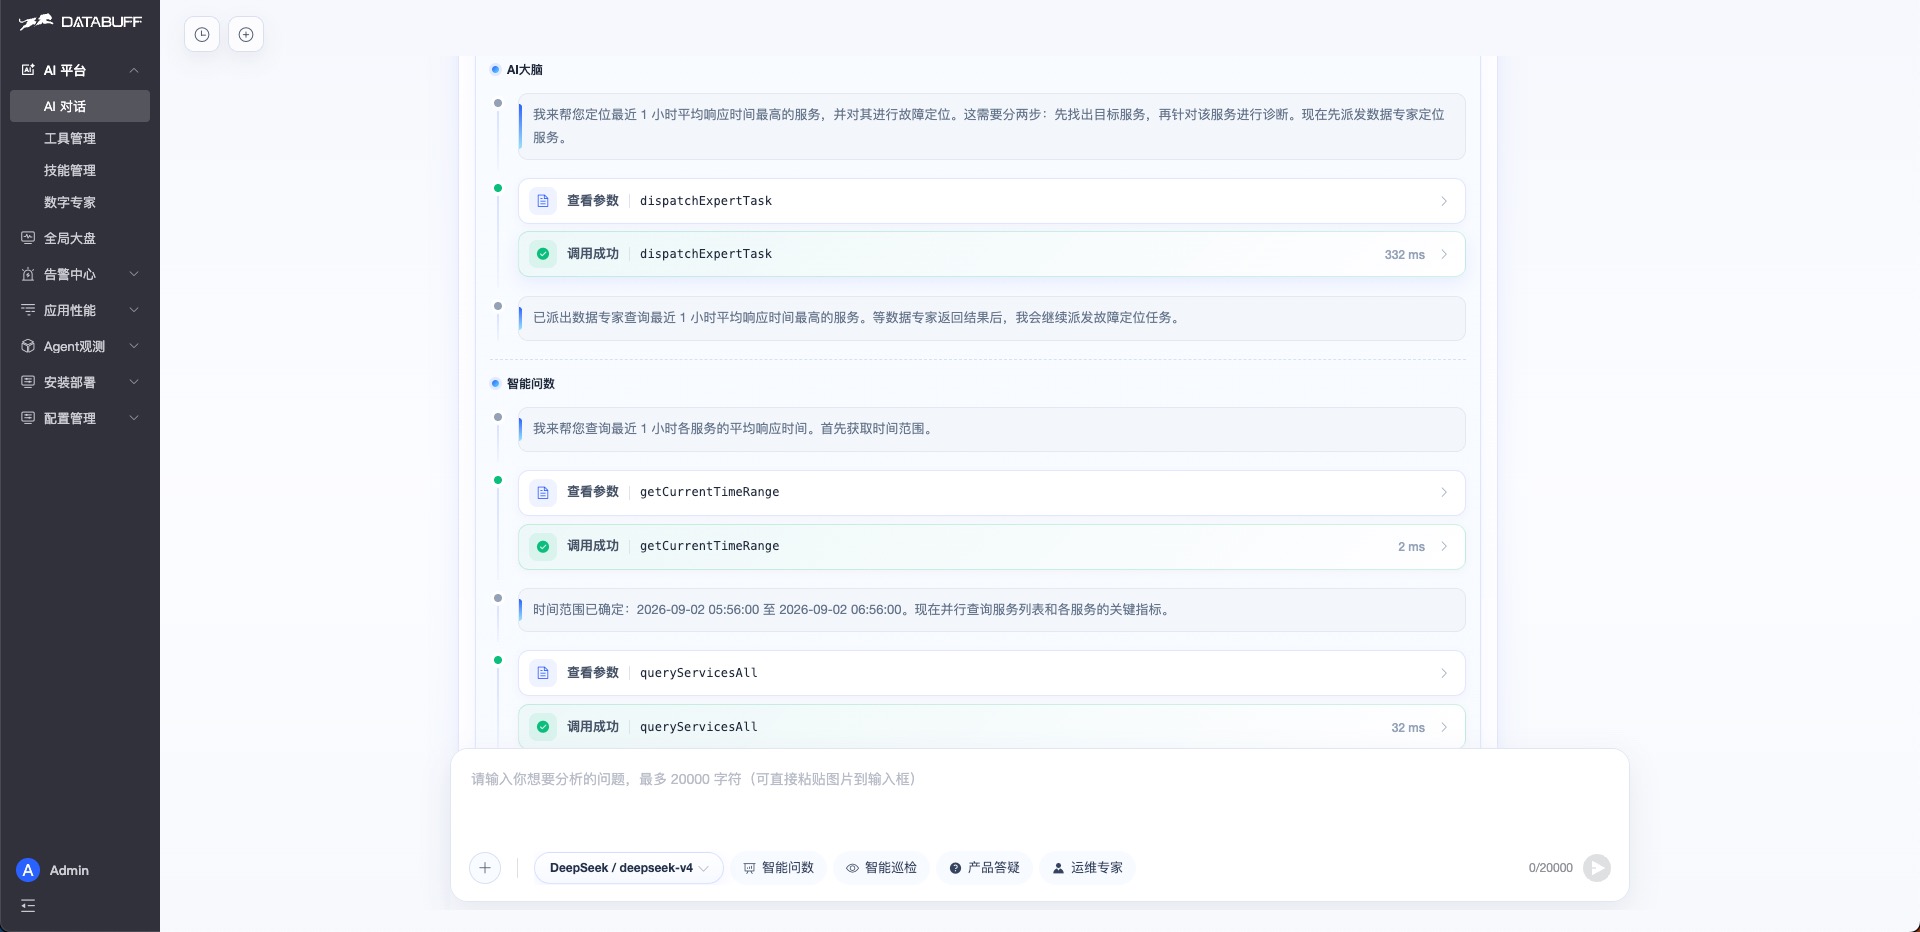
- 表上 service-a 平均 240ms,是这批里最高的。
- 对比一下,service-b 是 70ms,service-a 大约是它的 3.4 倍,故障定位就围着 service-a 做。
- 两条 Java 入口错误率都是 0%,这一眼看着没事。MySQL 错误率 33.33% 是高,但它不是最慢那个,这会儿先不拿它当主对象。
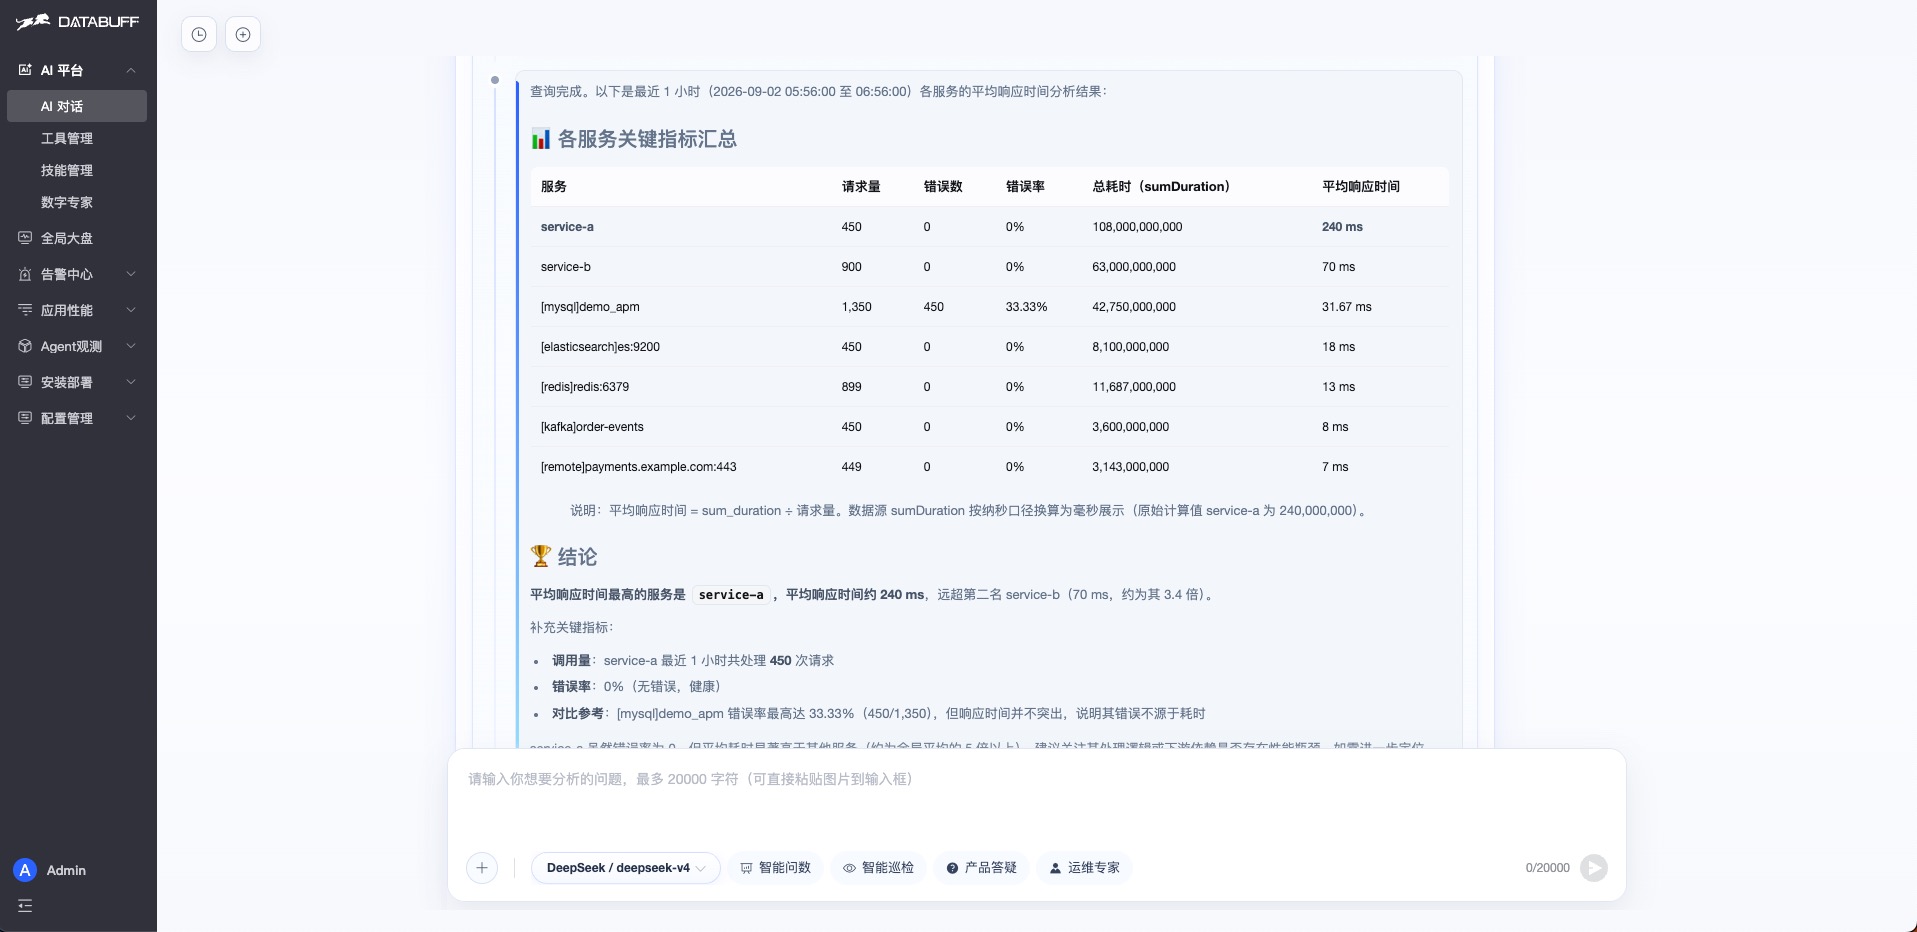
- 先看 service-a 自身:入口错误率 0%,没有 ERROR,没有失败 Trace,240ms 也是一条平线,不像刚炸过。
- 红点在下游
[mysql]demo_apm,挂着 60 条「入口错误率过高」。 - 自身是绿的,库一直在响,两页对不上。
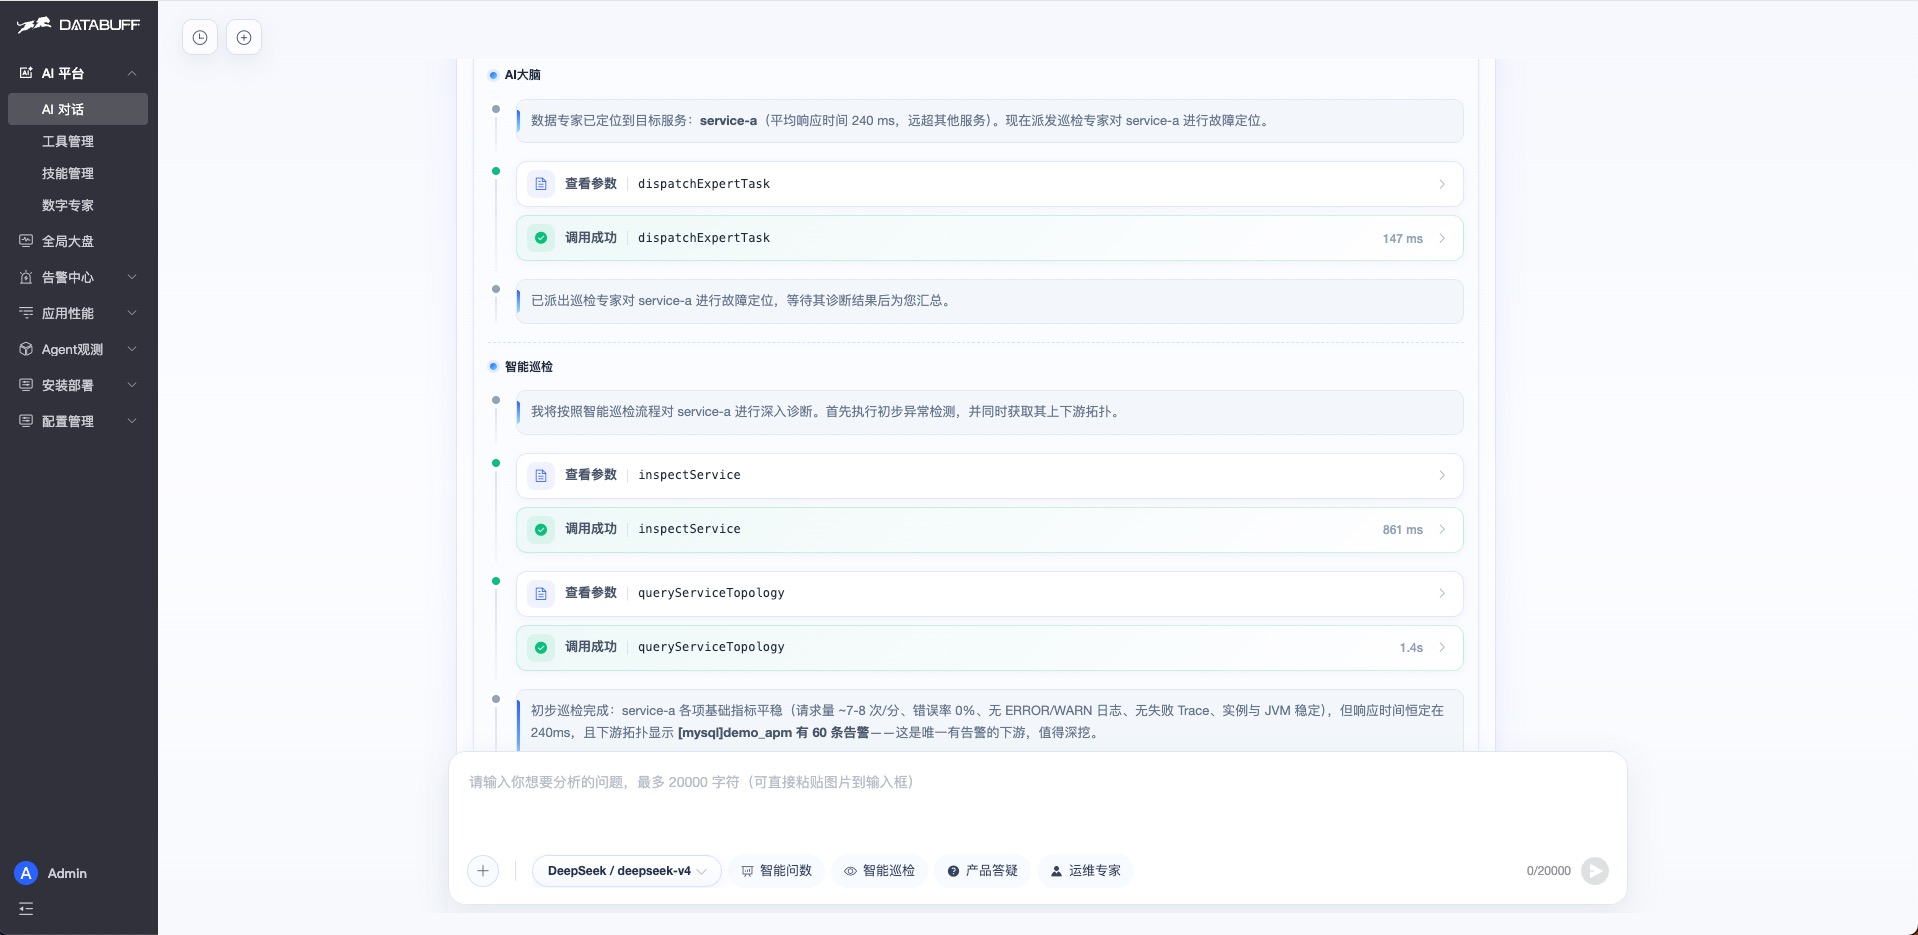
- 抽样打开的 Trace 都是
GET /demo/checkout,状态 200,耗时钉在 240ms,入口这一跳看不出坏事。 - 库那边告警还是 60 条,但依赖统计里 MySQL 错误写成 0。
- 两句对不上,只能拆开一条链看。
- 出事的那一跳是
SELECT demo_inventory,抛了InsufficientStockException。 - 入口这边却仍回 200。再捞同一条日志,对上 SKU
DEMO-10001,库存只剩 2 件。 - service-a 那边记的是 service-b 回了 200,所以入口一直是绿的,没冒红。
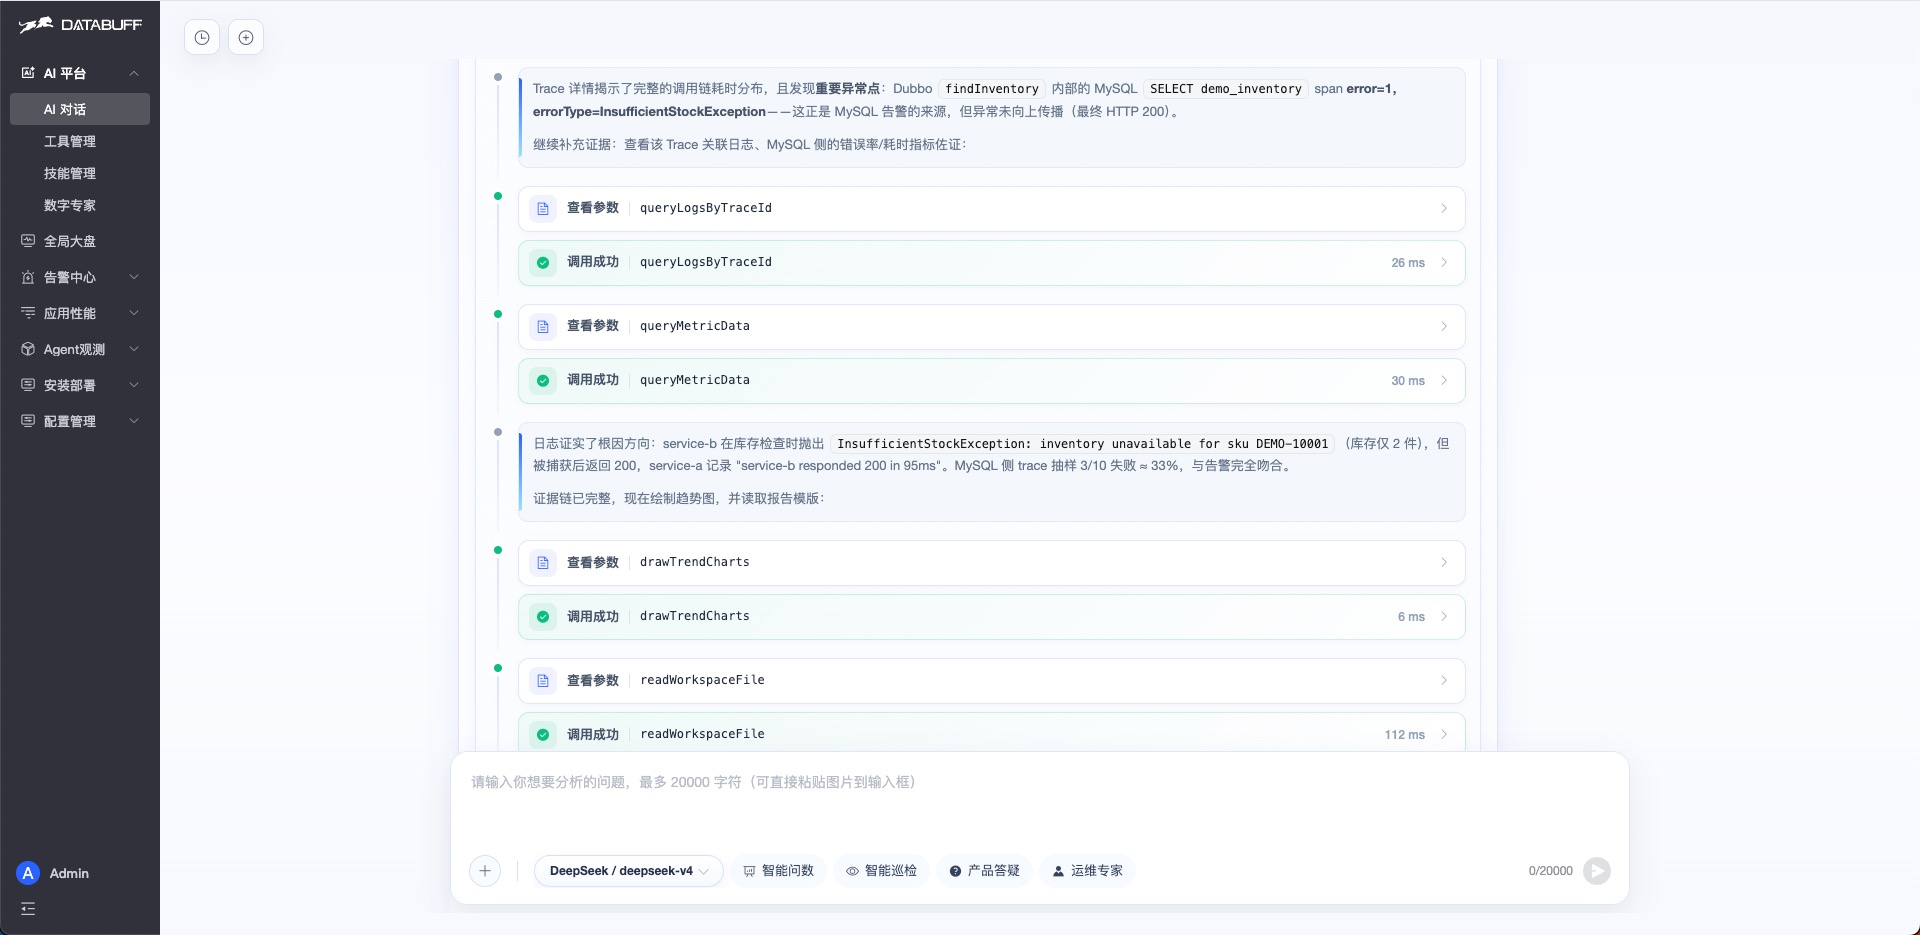
- 对话最后给出一份 HTML 巡检报告,不是只丢一句「查完了」。
- 判定、趋势、调用树、建议,下一节按报告自己的章节来读,这里不抢先抄一遍。
先看判定。报告写的是「关注」,意思是这条链值得看,不是服务已经挂了。240ms 在报告里被写成串行固有延迟,不是突然冒出来的尖峰。
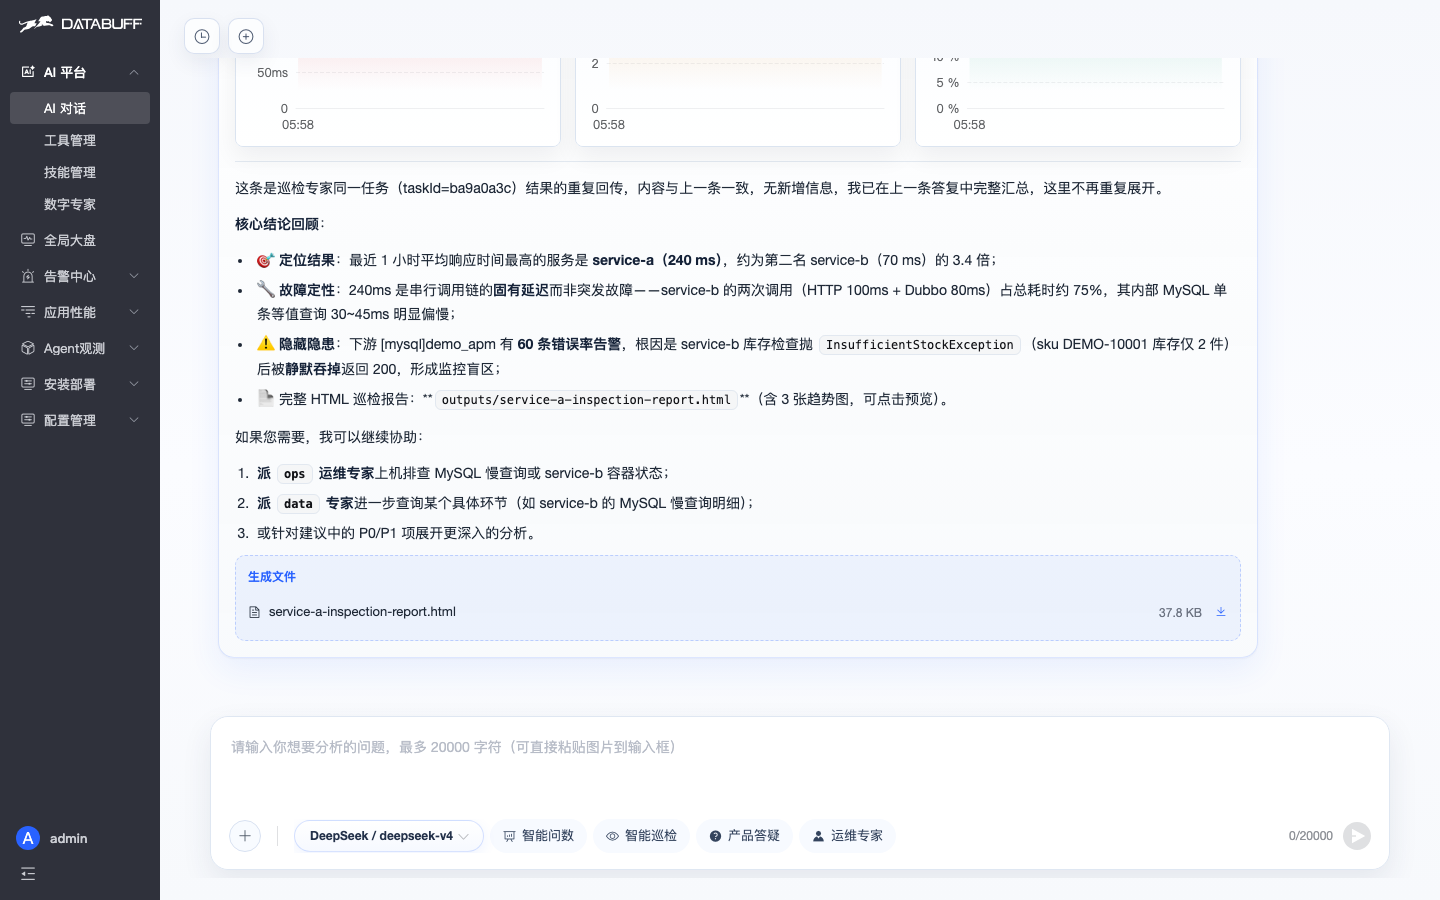
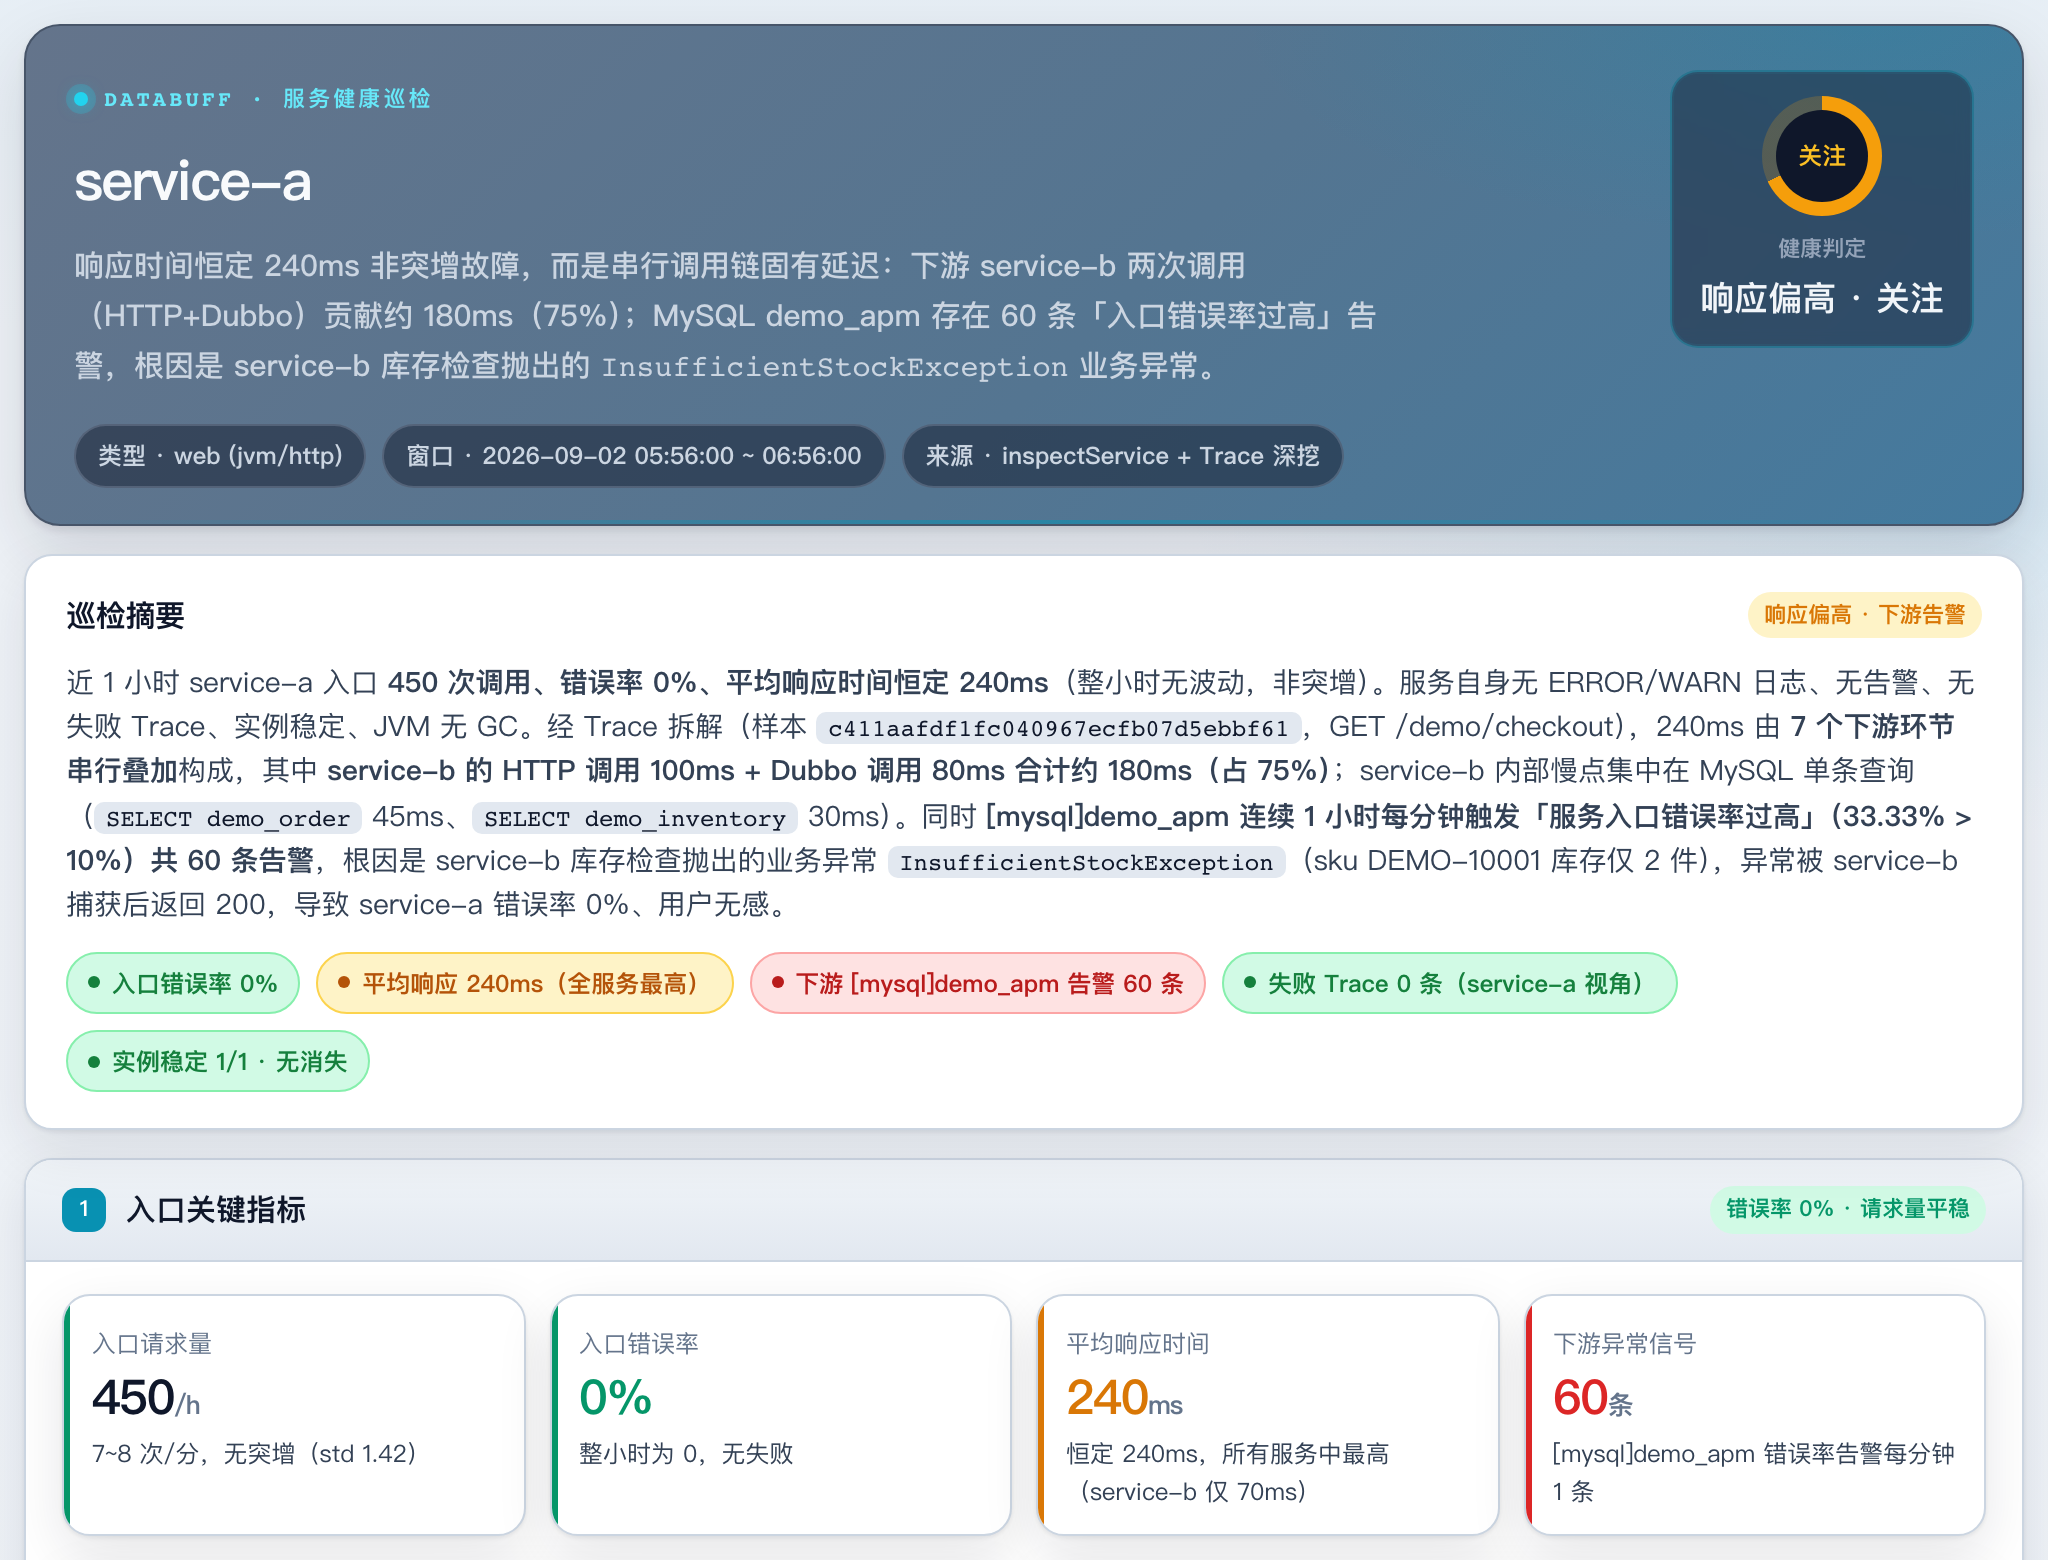
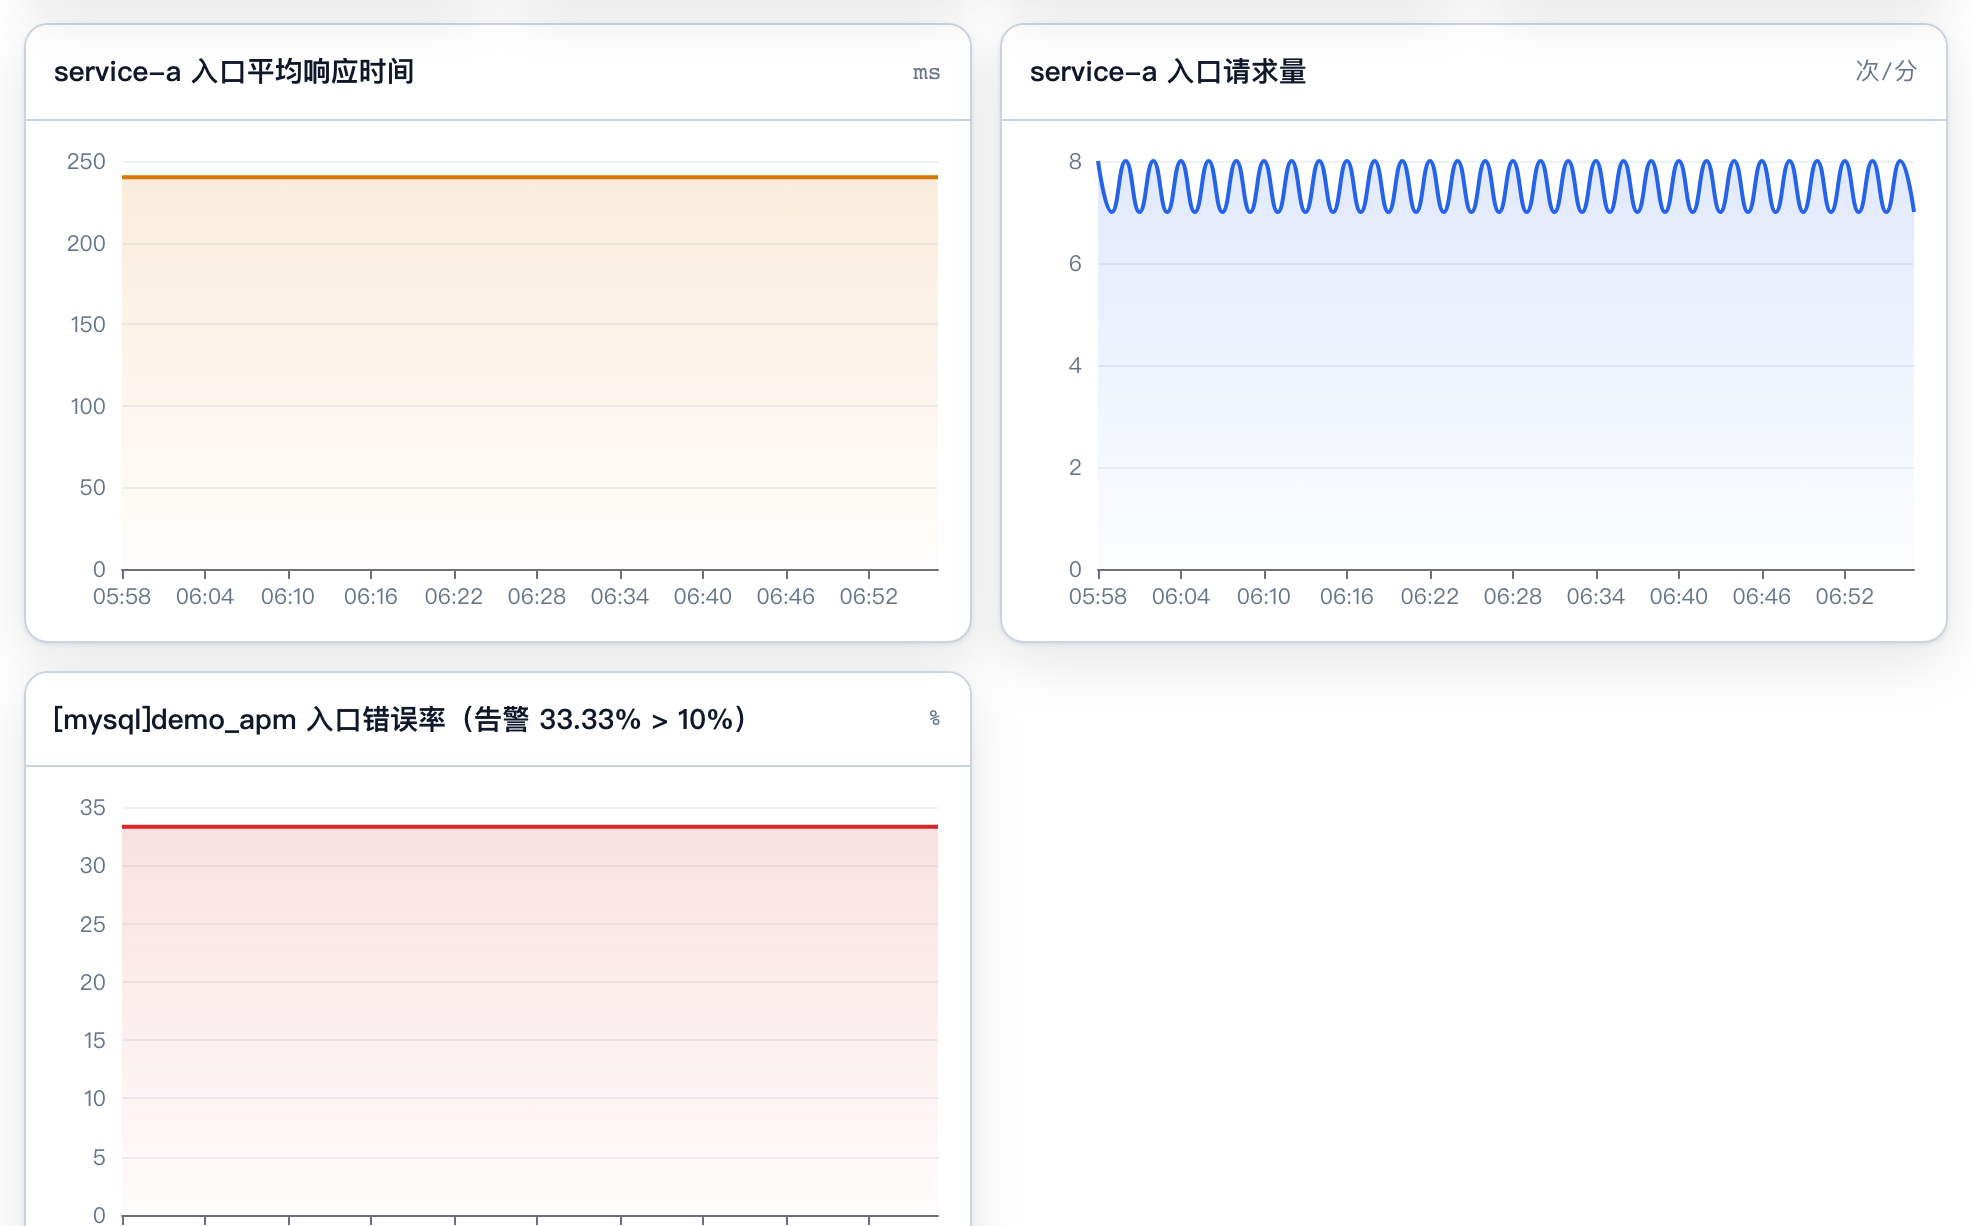
再看趋势。三张图都是平线。响应时间钉在 240ms,没动;请求量大约 7~8 次/分,也平;MySQL 错误率 33.33%,同样平。所以这不是偶发抖动——慢是这一小时里一直慢,告警也是一直在响。
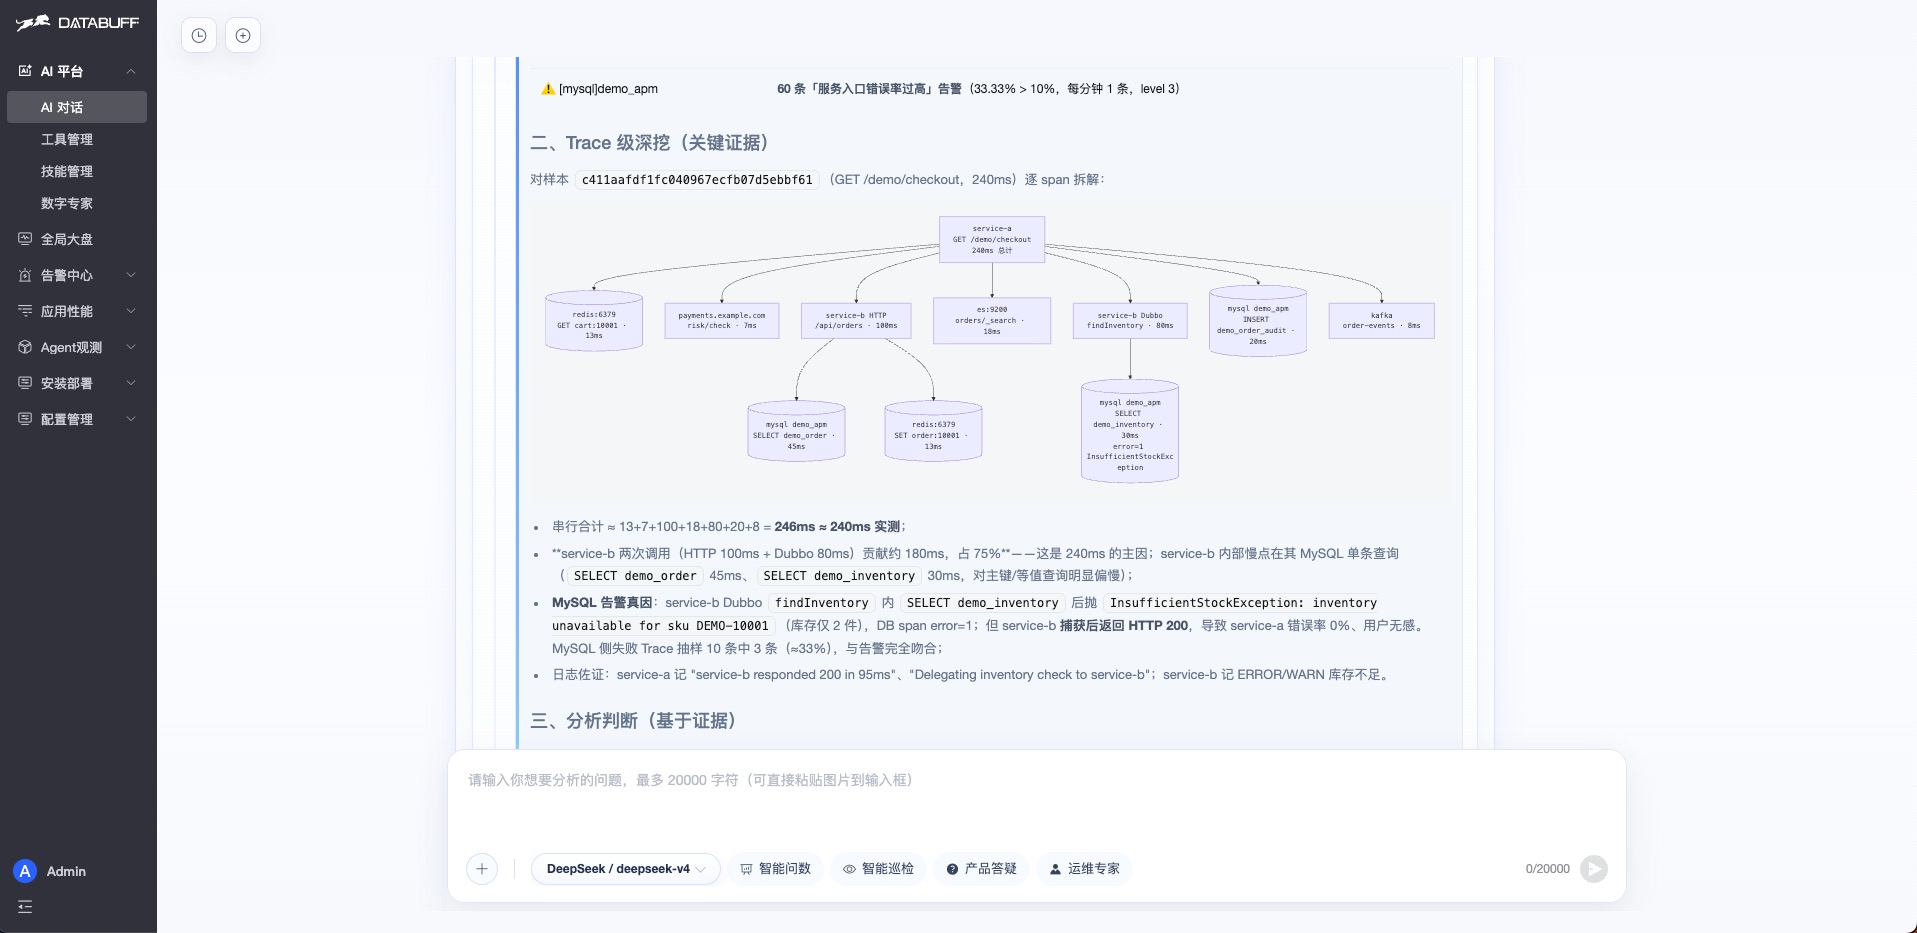
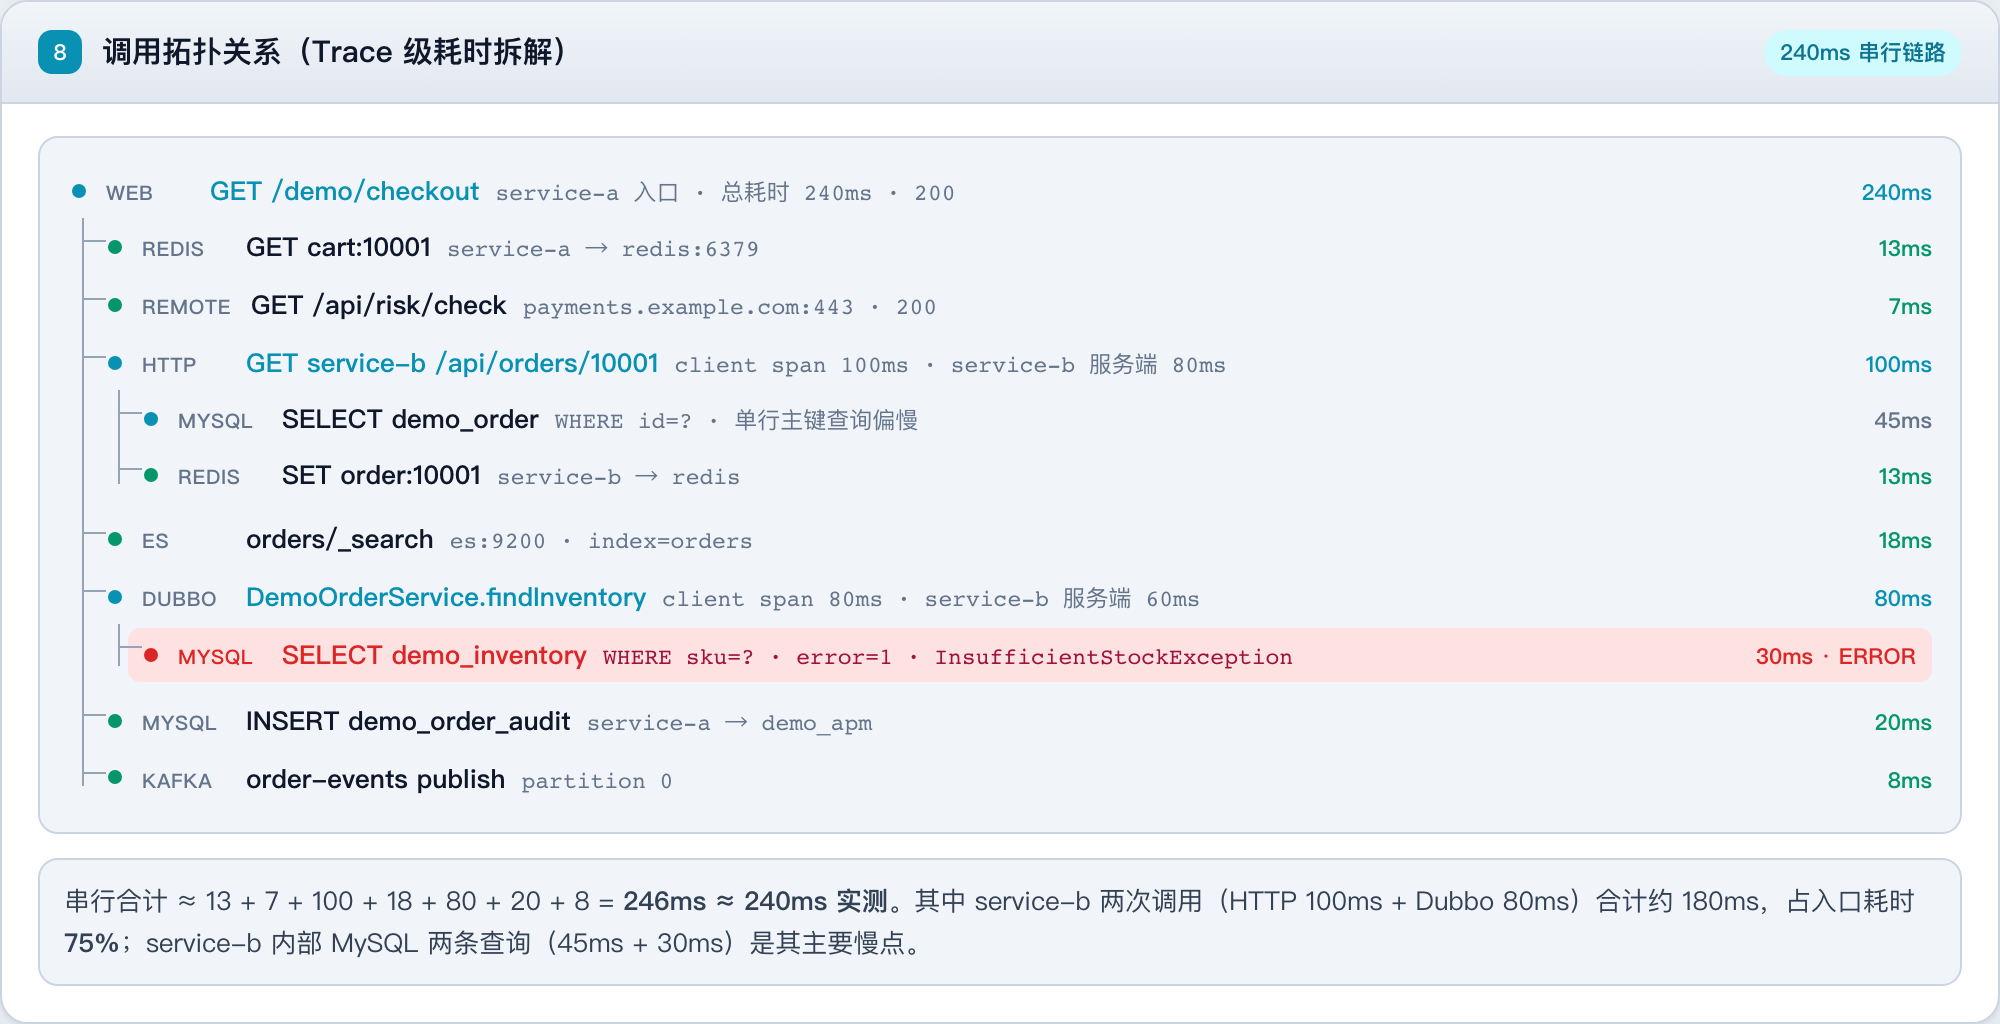
接着看调用树。打 service-b 的 HTTP 大约 100ms,Dubbo 那一跳大约 80ms,两跳加起来约占整条 240ms 的 75%。红点落在 SELECT demo_inventory。把各跳加总,大约 246ms,和入口记的 240ms 对得上,不是另有一截没画出来。
最后看建议。响应时间这边,瓶颈写在两次打 service-b,再加上两条偏慢的 SELECT,分别是 45ms 和 30ms。告警这边,原因写成库存不足被吞:SKU DEMO-10001,库存 2 件。入口回 200,把这件事盖住了。
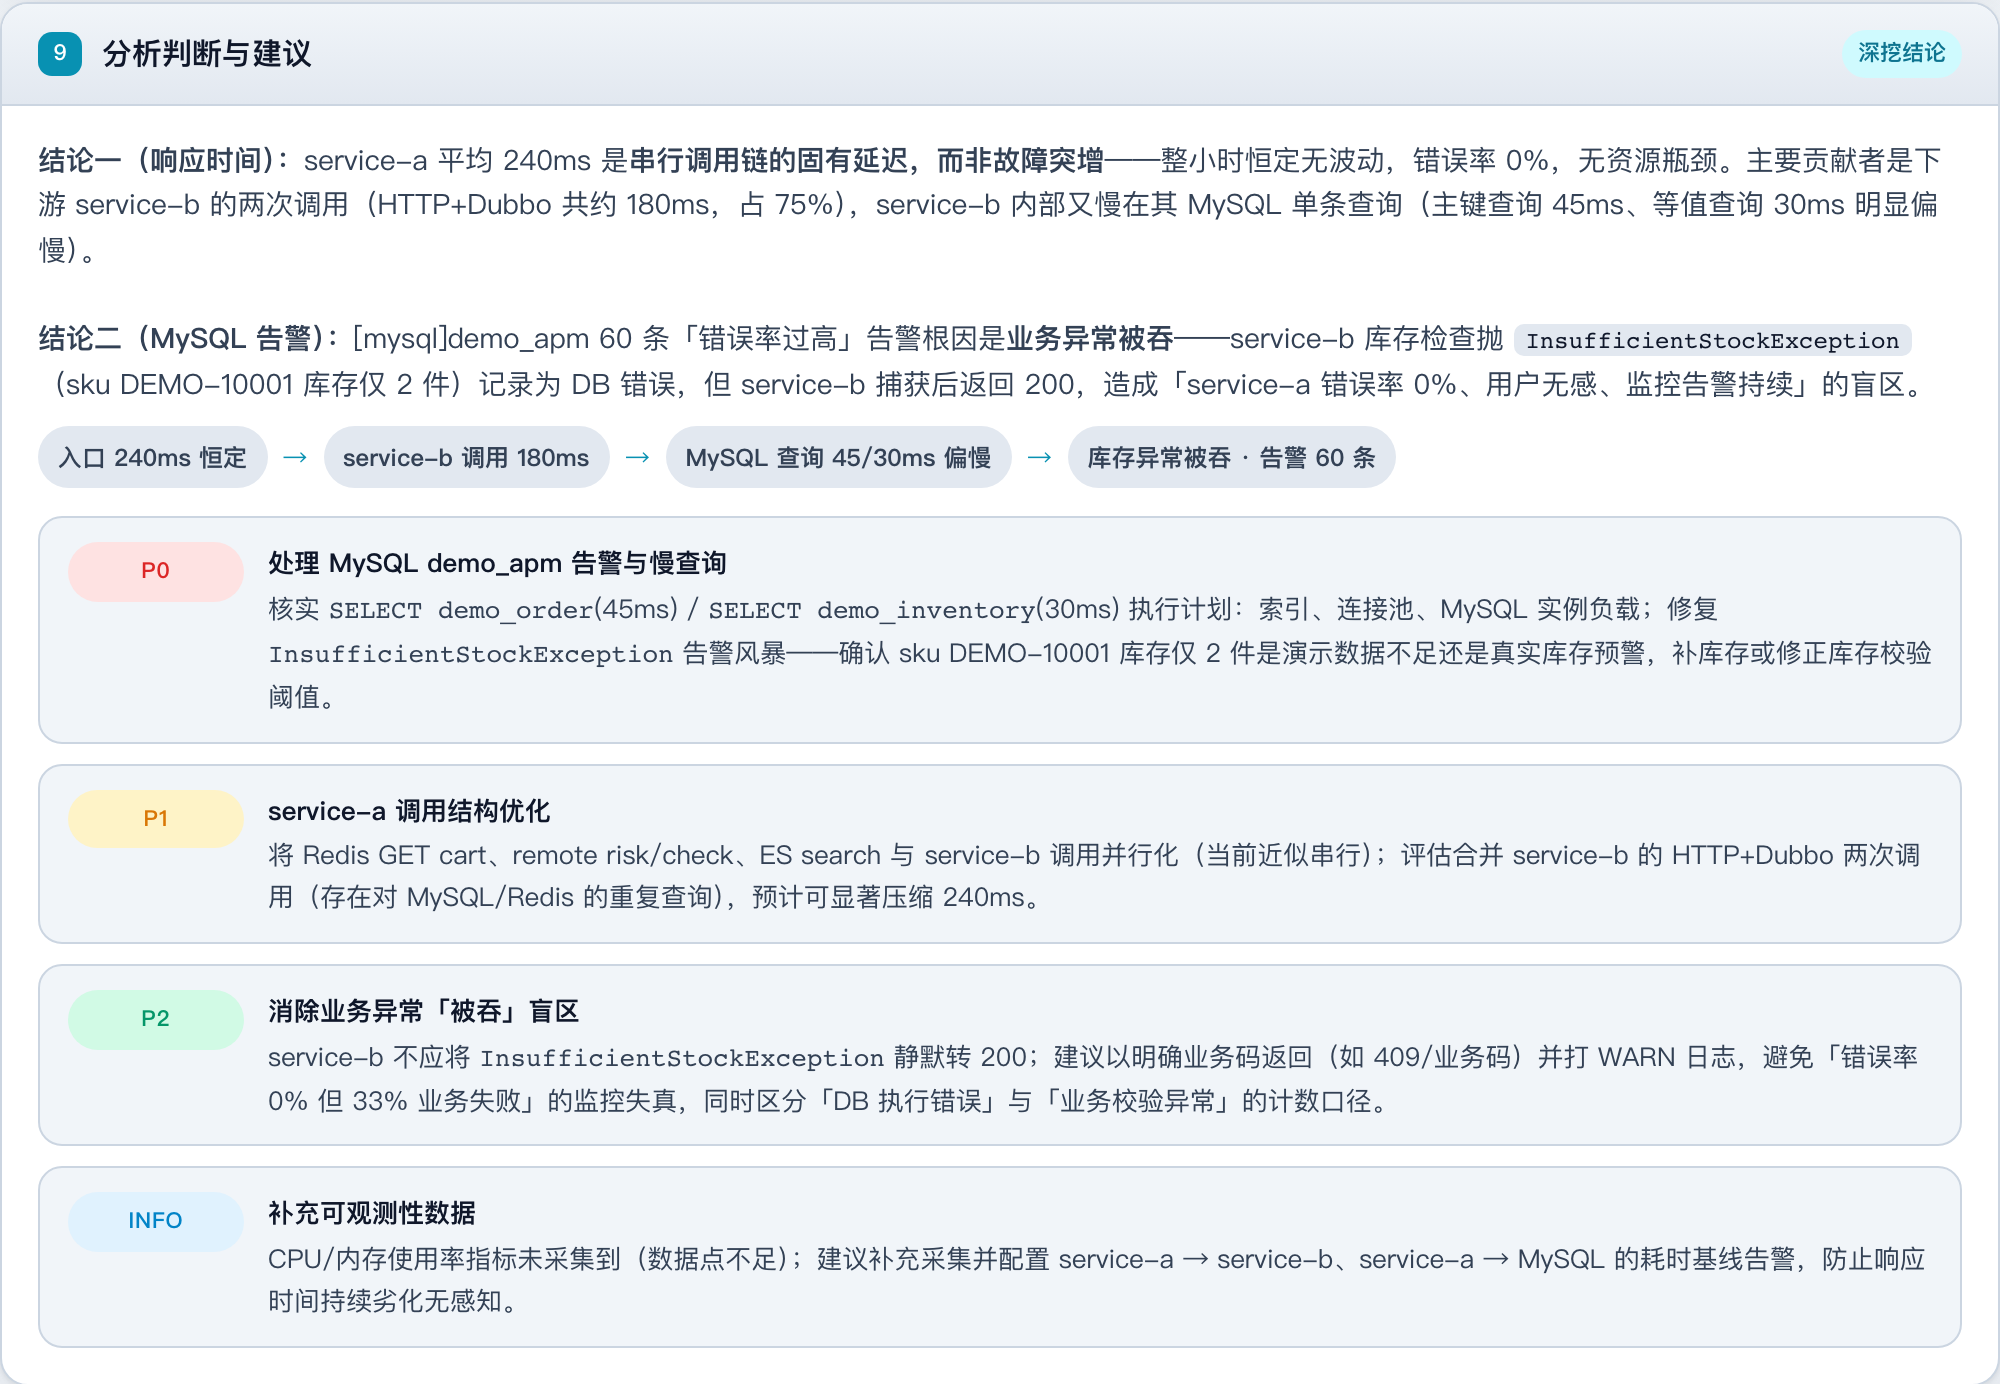
| 优先级 | 报告写了什么 |
|---|---|
| P0 | 核对两条 SELECT 为什么要 45ms / 30ms;库存 2 件是演示数据还是真缺货 |
| P1 | 评估并行、合并两次打 service-b。这是建议,没测能快多少 |
| P2 | 库存不足不要静默转成 200 |
对照的是同一件事:找出最近 1 小时最慢的服务,再定位到库存不足被吞成 200。不是两套不同的故障,是同一套活两边各做一遍。
右边「约 3 分钟」是这次对话从提问到给出报告的墙钟时间,实测的。左边「约 40 分钟」是熟手把五项串起来的估计,没有另做一次人工秒表。
| 这一项 | 人工怎么做 | 熟手估计 | 这次 AI 对话 |
|---|---|---|---|
| Metric | 打开服务列表,按耗时排序,自己点名最慢的那个 | 约 5 分钟 | 约 30 秒 |
| 拓扑 | 另开关系图,把下游告警和这个服务对上 | 约 5 分钟 | 约 30 秒 |
| 调用链 | 入口已经是 200,再点开瀑布图找卡住的那一跳 | 约 10 分钟 | 约 1 分钟 |
| 日志 | 把调用 ID 拷出来,换一页再搜原文 | 约 8 分钟 | 约 30 秒 |
| 写出报告 | 自己把四页对上的东西写成一份结论 | 约 12 分钟 | 约 20 秒 |
| 合计 | 五项串起来,还要对齐时间窗 | 约 40 分钟 | 约 3 分钟 |
合计约 40 分钟对约 3 分钟,快了大约 13 倍。
这条对话大约 3 分钟。最慢的是 service-a,红点在库上,库存不足被业务吞成了 200。Metric、拓扑、调用链、日志四页是对上了,人不用再拷着调用 ID 在四页之间来回切。
对上了不等于这件事结了。库存 2 件补不补、200 该不该这样吞下去、那两条 SELECT 还动不动,报告里写了建议,但拍板还是人来。