一次下单,会经过哪些服务?OpenTelemetry 能把应用处理请求、调用下游、访问数据库的过程记录下来。一整次请求的记录叫 Trace(调用链),里面每段操作叫 Span。
先看三次下单。入口是 A(service-a),它有时调用 B(service-b),也会直接查 MySQL;B 同样访问这个数据库。下面用简化数据说明,三次请求都成功。
- B · 80 ms
- MySQL · 40 ms
- MySQL · 10 ms
- B · 120 ms
- MySQL · 60 ms
- MySQL · 20 ms
- MySQL · 10 ms
这一次没有调用 B。缩进表示谁调用谁:①② 各查库两次,③ 查库一次。这是省略了内部操作的调用示意,编号和数值均为教学示例。
这里的调用都要等待下游返回。例如,B 处理请求用了 80 ms,其中已经包含等 MySQL 返回的 40 ms,不能再相加成 120 ms。A 的入口耗时也是从接到请求到返回结果的整段时间。
单条链能看清一次请求。可当请求多起来,你还想知道:整个系统谁依赖谁?从 A 出发,时间主要花在哪条路径上?逐条翻记录就很费劲了。
DataBuff 是 OpenTelemetry 的 AI Native 后端:接收应用上报的数据,提供查询页面,也让 AI 专家通过工具查询、分析这些数据。项目已开源,GitHub 地址:https://github.com/databufflabs/databuff。这里先沿这三条 Trace,看看它如何生成全局拓扑和服务流。
| 最终生成什么 | 保留什么信息 |
|---|---|
| 全局拓扑 | 把调用关系合成一张网,看整个系统谁依赖谁。 |
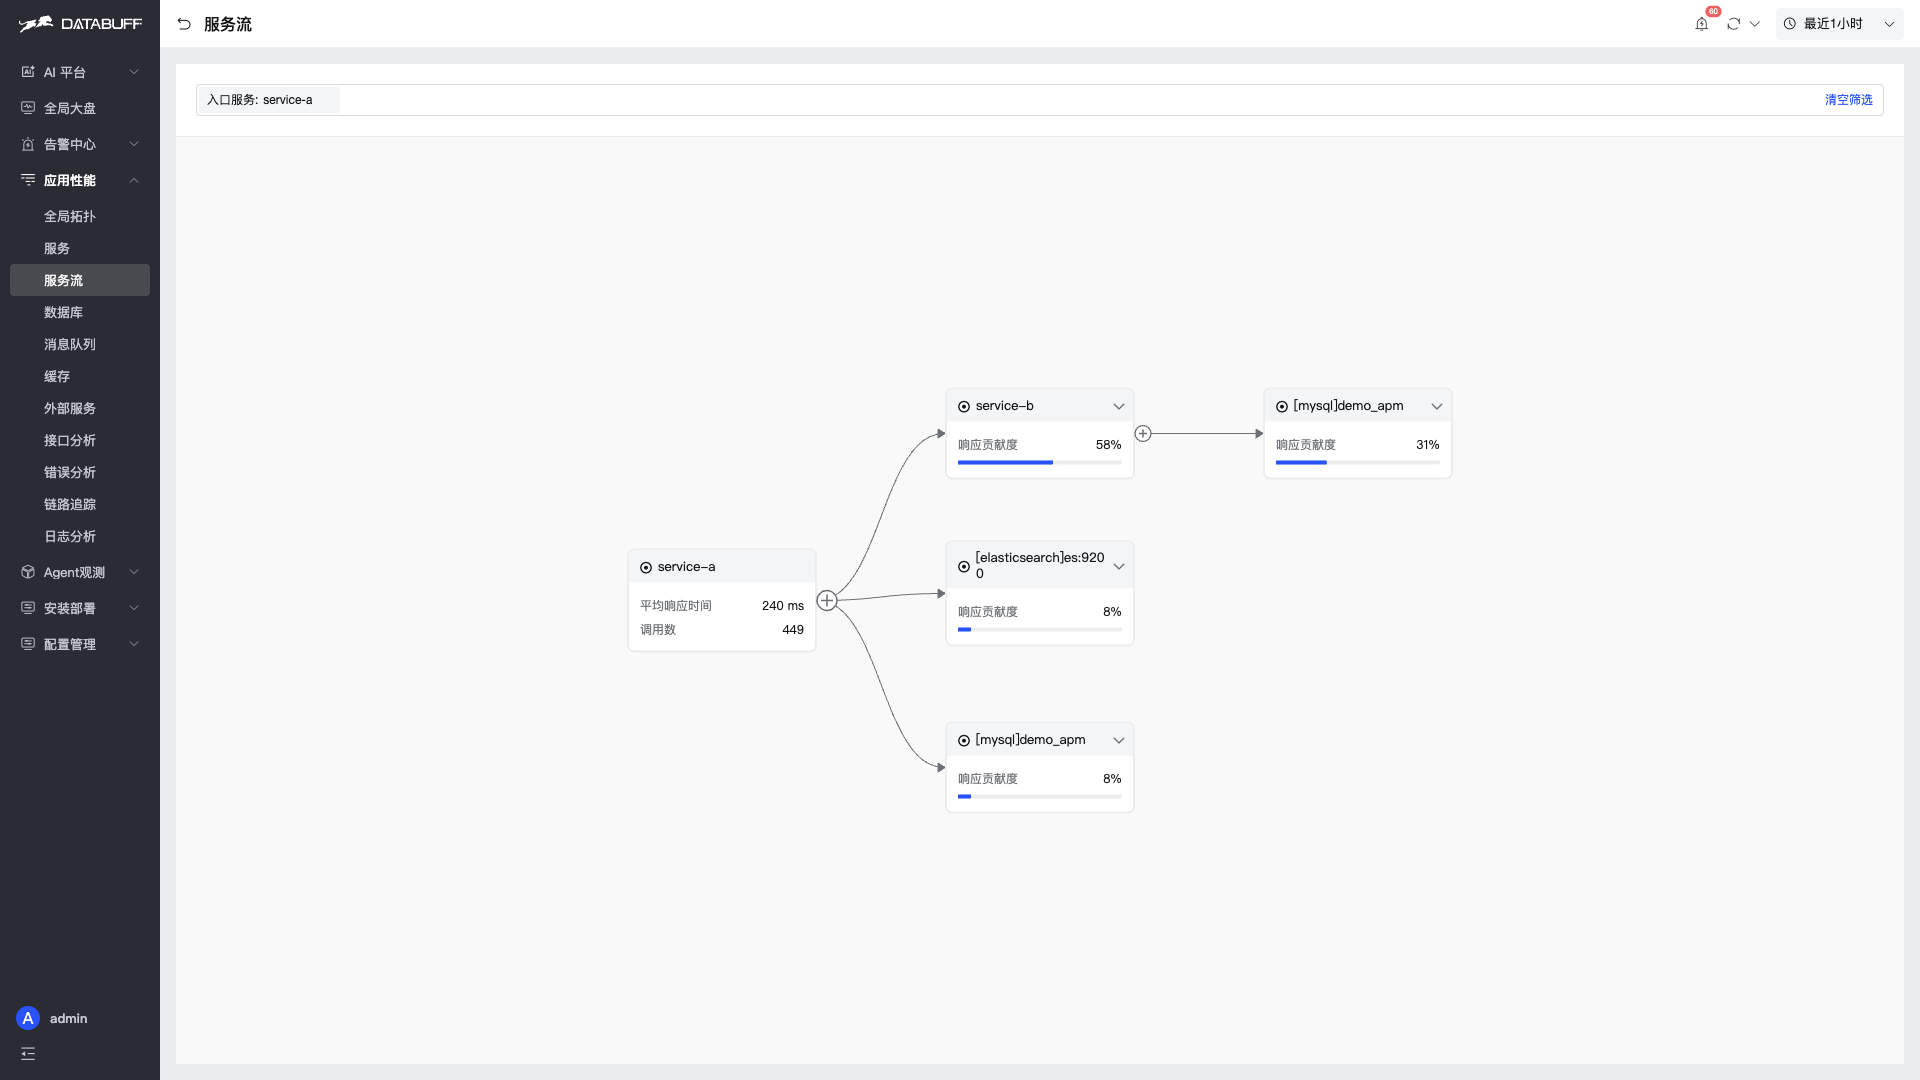
| 服务流 | 保留入口和调用路径,看从 A 经过谁,以及各路径的耗时比例。 |
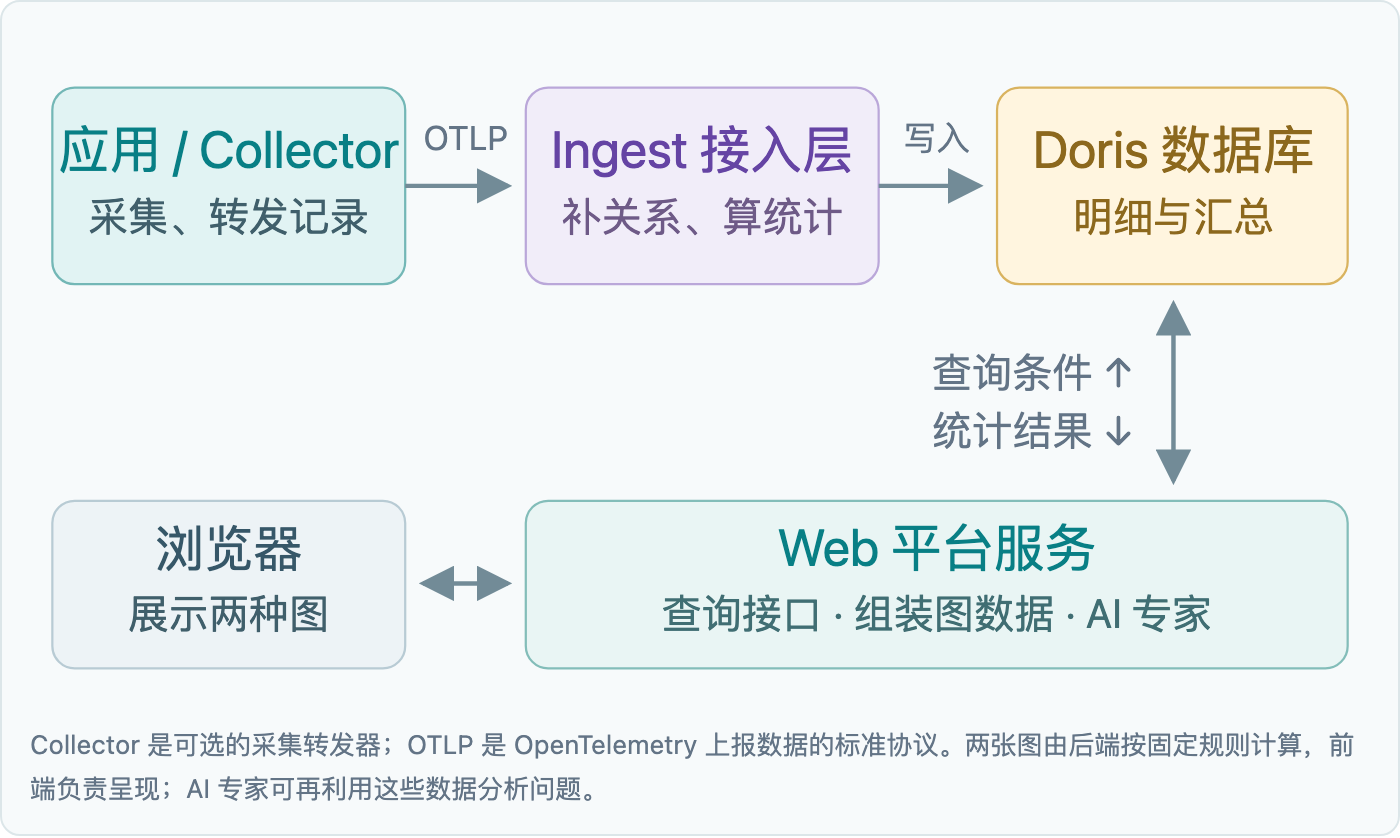
A、B 的记录可能分批到达。每次请求都有一个关联编号 trace_id,接入层先按它把片段放到一起。每个片段还有自己的编号,以及父片段编号 parent_span_id,用来说明“这个操作是在谁的处理过程中发起的”。
- s1 · A 接收下单请求 · 100 ms(无父片段:这是入口)
- s2 · A 发起对 B 的调用 · 80 ms(父片段 = s1)
- s3 · B 接到请求 · 80 ms(父片段 = s2 → s2 属于 A → B 的上游是 A)
- s4 · B 查 MySQL · 40 ms(父片段 = s3)
- s5 · A 直接查 MySQL · 10 ms(父片段 = s1 → 这次查库直接属于 A)
s1~s5 是便于阅读的短编号。s2 是 A 等待 B 的时间,s3 是 B 处理请求的时间,示例中都设为 80 ms;实际两端耗时可能不同,但仍只发生了一次 A→B 调用。
Ingest 看到 s3 的父片段是 s2,而 s2 属于 A,就能给 B 补上“上游是 A”,同时给 A 的调用记录补上“下游是 B”。s1、s2 都属于 A,它们之间就不画一条 A→A 的服务连线。接入层会暂存等待后续片段,但超时仍要继续处理,不能保证每次都收齐。
s4 是 B 上的探针记录的。它带着数据库类型和库名,Ingest 可以据此识别访问的组件,并记下 B 到这个组件的关系。
- B 的查库记录 s4:
db.system = mysql,db.name = demo_apm - 识别组件节点:
[mysql]demo_apm - 记下访问关系:B → MySQL,40 ms,成功
s5 则补出 A→同一个 MySQL。后文简写为 MySQL,具体字段能否识别取决于实际采集内容。
Redis、消息队列也按各自的组件信息识别。为画出依赖,不必给每个中间件再装探针;这也不等于已经采到了它们内部的全部运行指标。
统计前,要先分清在数什么。A 接了几次请求,看 A 的入口记录;B 查了几次库,看 B 的查库记录。Trace ① 虽然列出 5 个 Span,A 接到的下单请求仍然只有 1 次。
- 按用途选记录:A 的请求数看 s1;B 的查库次数看 s4
- 提取各自的数字:对应调用数 +1,错误时错误数 +1,耗时 = 结束 − 开始
- 按分钟汇总:同类记录相加,保留次数与耗时总和
这是第二种“聚合”:把多次调用做统计。前一步按 Trace ID 归组,是把一次请求的片段放到一起。
假设开头三次请求的各段操作都在同一分钟内结束,A 调 B 与 B 接收端的耗时也取相同值,汇总后是这样:
| 开头三次请求汇总后 | 次数 | 累计耗时 | 平均耗时 |
|---|---|---|---|
| A 入口 | 3 | 400 ms | 约 133 ms |
| A 调 B | 2 | 200 ms | 100 ms |
| B 查 MySQL | 2 | 100 ms | 50 ms |
| A 直接查 MySQL | 3 | 40 ms | 约 13 ms |
平均耗时用累计耗时 ÷ 调用数,错误率用错误次数 ÷ 调用数。示例中错误率都是 0%。查询多个分钟时,也要先合计次数和耗时,不能直接平均各分钟的平均值。
服务流还会保留入口和途经路径。例如 A→B→库,上一层路径是 A→B;A→库,上一层则是 A。把这两类查库记录分开存,后面才能知道它们各自该挂在树的哪里。
落库的是明细和统计,不是一张预先画好的图片。主要分成下面几类:
| 数据与代表表 | 存什么 | 用在哪里 |
|---|---|---|
调用链明细 trace_dc_span | 补过关系的各条 Span | 打开某次请求看细节 |
服务统计 metric_service | 服务接收请求的次数、耗时等 | 服务指标;让有请求但没连线的服务也能显示 |
调用双方统计 metric_service_http、metric_service_db 等 | A→B、A→库、B→库的分钟统计 | 全局拓扑的连线与指标 |
入口路径统计 metric_service_flow | 入口、父子路径、各路径上的次数和耗时 | 构建服务流树 |
- 前端提交条件:时间范围;服务流还要选入口
- Web 查询 Doris:合并时段内的统计,组装节点与连线
- 前端收到结果:排列节点、画线,展示数字与状态
两种图分别查询自己的统计数据,打开页面时无需逐条扫描原始 Span。
后端合并所选时段的调用统计,同一服务身份只画一个节点,箭头由调用方指向被调用方。这里的节点代表服务或组件,不等于一台机器。
A、B 两端都统计了 A→B 时,当前实现优先采用 A 这一侧的统计,避免两份相加。连线的数据包括次数、错误率和平均耗时;节点告警另外查询、关联。
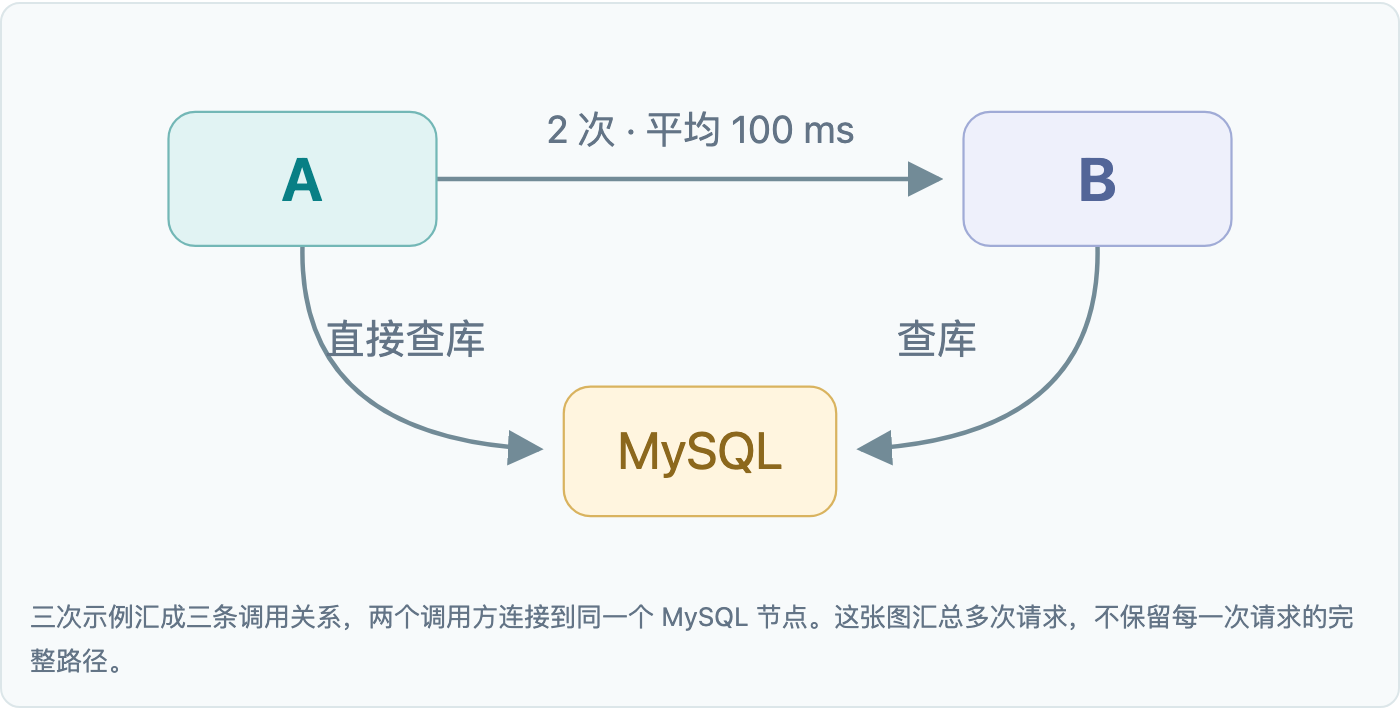
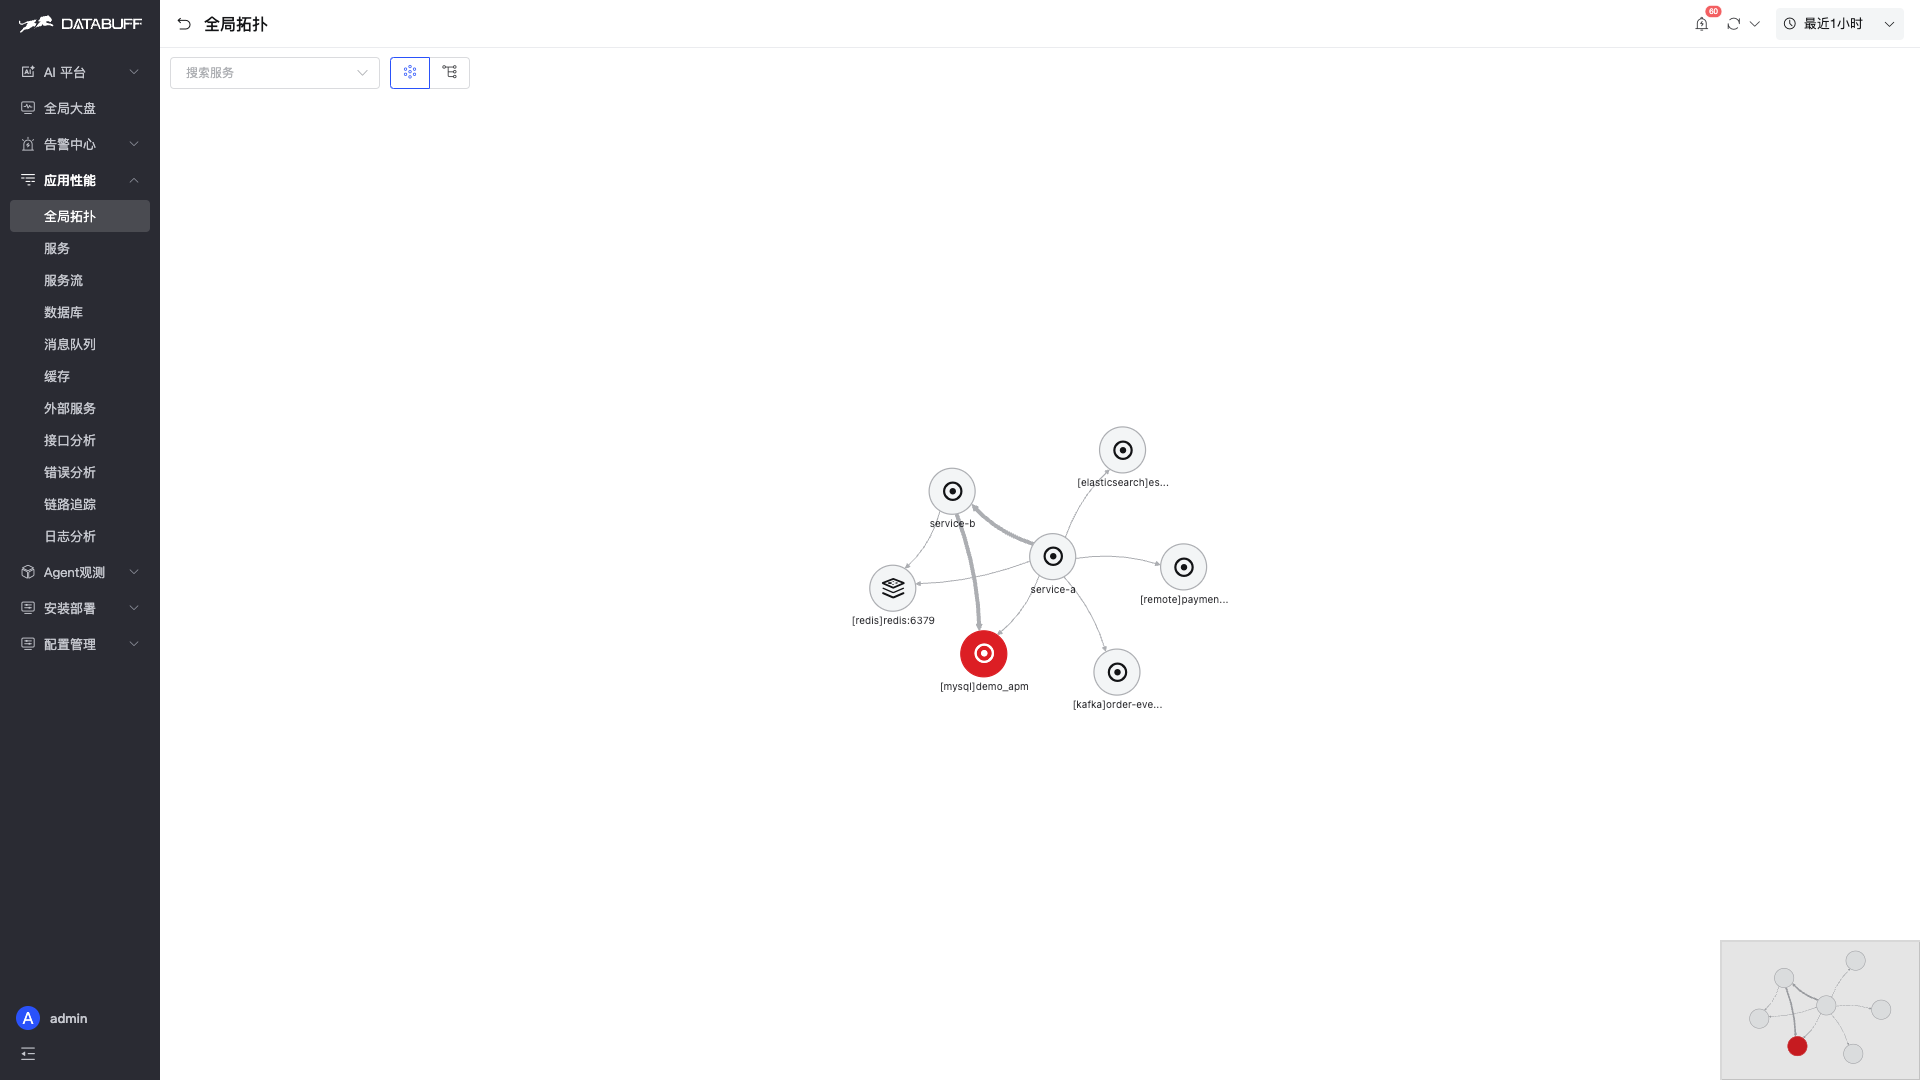
[mysql]demo_apm。红色来自该时段的节点告警,不能直接当作根因。后端先查出以 A 为入口的路径统计:A→B 挂在 A 下面,A→B→库挂在 B 下面,A→库直接挂在 A 下面。同一路径的多次调用合在一起,两条查库路径则分别显示。
接成树后,每个路径节点的累计耗时除以入口累计耗时,得到页面上的响应贡献度。前端用这个比例排列分支。它反映所选时段多次请求的耗时分布,不是某一次下单的执行顺序。
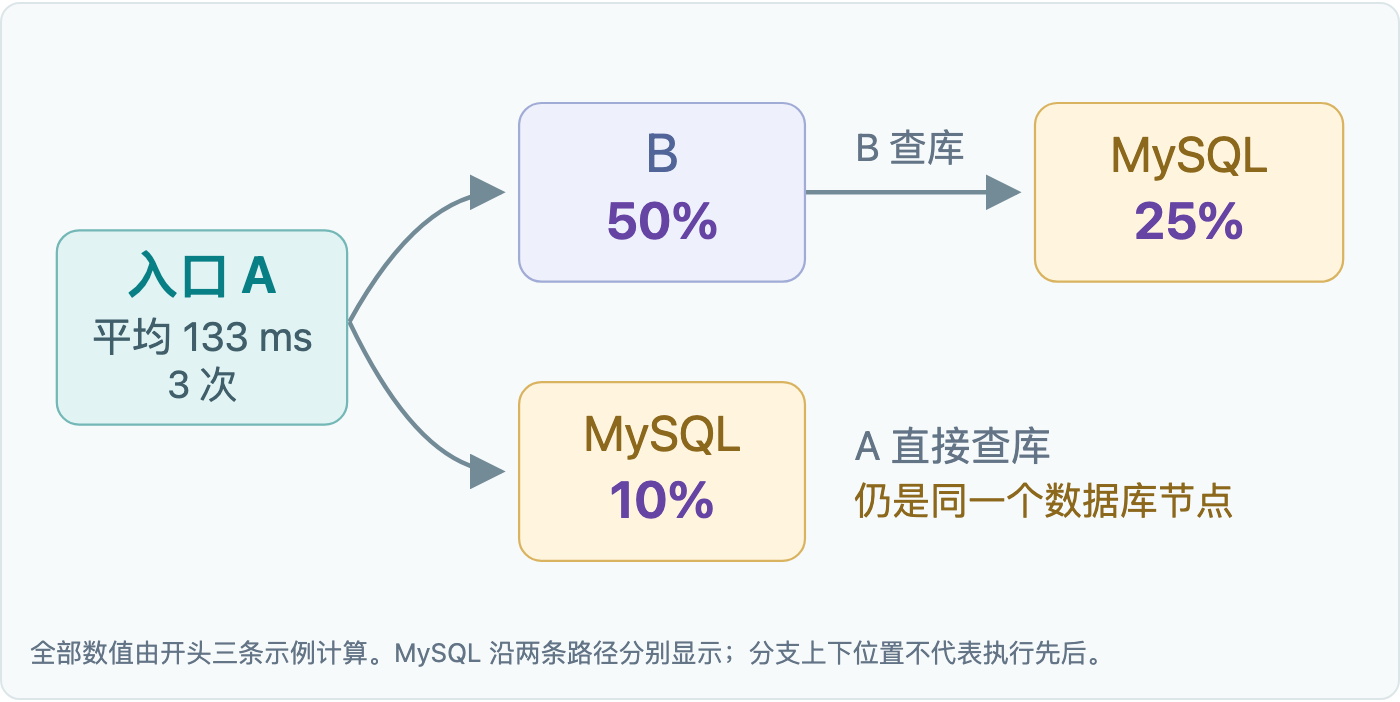
响应贡献度 = 该路径节点累计耗时 ÷ 入口累计耗时
B:200 ÷ 400 = 50% | B 下方的库:100 ÷ 400 = 25%
A 直接查库:40 ÷ 400 = 10%
MySQL 出现两次,是为了分开两条访问路径,不表示部署了两个数据库。25% 也是相对入口 A,不能读成“占 B 的 25%”。B 的 50% 已包含这里的查库等待,50% 与 25% 不能相加;有并行调用时,不同分支的时间也可能重叠。
这些比例也不要求加到 100%。入口处理请求还可能花时间做计算、等待其他操作;这张图没有把整次响应拆成互不重叠的时间份额。
开源 APM 对这类关系也有不同呈现。SkyWalking、SigNoz 都有依赖拓扑;Jaeger 的深度依赖图还能从搜索结果里的 Trace 展示经过指定服务的路径。
DataBuff 在这里做得比较完整:开源版本同时提供全局依赖视图,以及基于分钟汇总、按入口展开路径并标注响应贡献度的服务流。两张图分别帮你认清系统关系和缩小排查范围。
新调用记录经过处理、写入数据库后,再刷新页面或调整时间范围,图就会按查到的数据重新生成。没有采到的调用,或异步调用没有传递关联信息,都可能让图缺一条线;筛选和展示数量限制也会影响结果。
排障时,全局拓扑帮你认依赖,服务流帮你找值得检查的路径。贡献度高或节点变红,都只是线索:还要比较正常时段的响应时间和错误率,再到调用链里确认具体哪段操作慢。